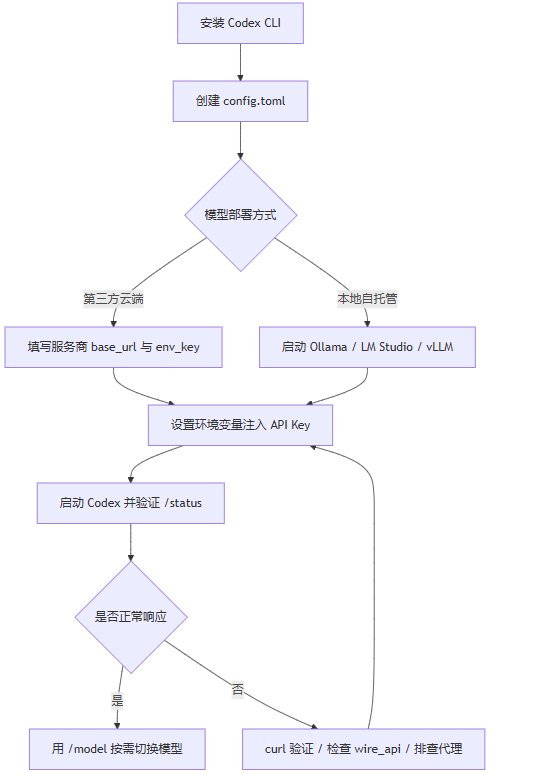
1. 项目缘起:为什么要在Windows上折腾OpenClaw?
最近几个月,AI Agent(智能体)的热度居高不下,OpenClaw作为一款开源的、功能强大的AI Agent框架,自然吸引了不少开发者和爱好者的目光。它支持多模型后端、具备工具调用和记忆能力,理论上可以构建出相当智能的自动化工作流。然而,官方文档和社区讨论大多以Linux或Docker环境为主,对于广大Windows用户,尤其是刚入门的朋友,部署过程堪称“步步惊心”。
我自己就在Windows 11上,尝试将OpenClaw接入腾讯混元大模型API以及本地运行的Ollama模型,完整走了一遍从环境准备、源码配置到最终成功对话的全过程。这期间踩的坑,从Python版本冲突、依赖包地狱,到令人抓狂的 llama_index 版本兼容性问题,再到模型API调用的各种诡异报错,几乎把能遇到的雷都踩了一遍。网上零散的教程要么步骤不全,要么环境不对,根本无法直接复现。
所以,这篇内容就是一份专为Windows环境定制的、血泪铸就的《OpenClaw避坑实操指南》。我不会只给你一个“完美”的命令列表,那没有意义。我会带你走一遍我实际走过的路,重点告诉你每个环节为什么这么做,以及当出现“那个”经典错误时,到底该怎么解决。我们的目标很明确:在你自己Windows电脑上,成功跑起一个能同时对话腾讯混元和本地Ollama模型的OpenClaw服务。
2. 环境准备:构建一个稳定且兼容的Python“地基”
在Windows上搞Python项目,环境管理是成功的一半。直接用系统Python或者随意安装,后续的依赖冲突会让你痛不欲生。我们的策略是:为OpenClaw创建一个独立的、纯净的虚拟环境。
2.1 Python版本与虚拟环境搭建
OpenClaw对Python版本有一定要求,经过实测, Python 3.10 是目前兼容性最好的选择。3.11或3.12可能会在某些底层依赖(如某些C扩展包)编译时遇到问题。
第一步:安装Python 3.10
- 前往Python官网下载Windows安装包(Windows installer (64-bit))。
- 安装时,务必勾选 “Add python.exe to PATH” 选项。这是老生常谈,但依然是无数新手的第一道坎。
- 安装完成后,打开命令提示符(CMD)或 PowerShell,输入 python --version 和 pip --version 确认安装成功,且版本为3.10.x。
第二步:使用venv创建虚拟环境 venv是Python自带的轻量级虚拟环境工具,比Anaconda更简洁,更适合这种单一项目。
|
1 2 3 4 5 |
# 在你喜欢的位置(例如D盘根目录)创建项目文件夹并进入 mkdir D:\openclaw_demo cd D:\openclaw_demo # 创建名为 `venv` 的虚拟环境 python -m venv venv |
执行后,会在当前目录生成一个 venv 文件夹,里面包含了一个独立的Python解释器和pip。
第三步:激活虚拟环境 这是关键步骤,确保所有后续操作都在这个“隔离罩”内进行。
- 在CMD中激活:
1
D:\openclaw_demo\venv\Scripts\activate.bat
- 在PowerShell中激活:
如果PowerShell提示“无法加载脚本,因为在此系统上禁止运行脚本”,需要以管理员身份打开PowerShell,执行 Set-ExecutionPolicy RemoteSigned 选择 Y ,然后再激活。 激活成功后,命令行提示符前会出现 (venv) 标识。1
D:\openclaw_demo\venv\Scripts\Activate.ps1
注意: 每次新开命令行窗口操作项目时,都必须先切换到项目目录并执行激活命令。忘记激活是导致“模块找不到”错误的常见原因。
2.2 关键依赖的预先手动安装
OpenClaw的依赖中, llama-index 及其相关包是版本冲突的重灾区。直接 pip install openclaw 很容易失败。我们需要先手动安装一些有特定版本要求或需要编译的包。
在激活的虚拟环境中,按顺序执行以下命令:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
# 1. 首先升级pip和setuptools到最新,避免安装时因工具过旧出错 pip install --upgrade pip setuptools wheel # 2. 安装PyTorch。OpenClaw的某些嵌入模型或工具依赖它。 # 访问 https://pytorch.org/get-started/locally/ 获取最新命令。 # 对于大多数Windows用户,没有独立GPU或使用CPU,以下命令足够: pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cpu # 3. 安装特定版本的llama-index。这是最大的坑!新版本API变动巨大。 # 经过反复测试,0.9.x 版本与当前OpenClaw代码兼容性较好。 pip install "llama-index>=0.9.0,<0.10.0" # 4. 安装llama-index的核心依赖包,同样锁定版本范围 pip install "llama-index-core>=0.9.0,<0.10.0" pip install "llama-index-llms-openai>=0.9.0,<0.10.0" pip install "llama-index-embeddings-openai>=0.9.0,<0.10.0" # 5. 安装OpenAI兼容层。因为我们要接入的腾讯混元API是兼容OpenAI格式的。 pip install openai |
这一步完成后,你的环境已经具备了运行OpenClaw最核心、也最容易出错的依赖。如果任何一步安装失败,通常是网络超时或编译错误。对于编译错误(特别是涉及 grpcio 、 tokenizers 等),可以尝试搜索错误信息,通常需要安装Microsoft Visual C++ Build Tools。
3. 获取与配置OpenClaw:绕过源码陷阱
我们不直接从PyPI安装 openclaw 包,因为最新包可能仍有未修复的Bug,或者我们想修改配置。从GitHub拉取源码是更可控的方式。
3.1 克隆仓库与安装剩余依赖
确保在虚拟环境激活状态下,在项目目录执行:
|
1 2 3 |
# 克隆OpenClaw官方仓库(如果网络慢,可以考虑使用Gitee镜像) git clone https://github.com/Tencent/OpenClaw.git cd OpenClaw |
现在你的目录结构应该是 D:\openclaw_demo\OpenClaw 。
接下来,安装项目 requirements.txt 中定义的其他依赖。由于我们已经手动安装了一些,这里使用 pip 的 -e 参数以“可编辑模式”安装,这样对源码的修改能立刻生效。
|
1 |
pip install -e . |
这个命令会读取项目根目录下的 setup.py 或 pyproject.toml ,安装所有声明的依赖。如果遇到冲突,pip会尝试解决。如果解决失败,会提示错误信息,你需要根据错误信息判断是哪个包冲突,通常可以用 pip install 包名==具体版本 来覆盖安装。
3.2 配置文件详解与模型端点设置
OpenClaw的核心配置在于 config.yaml 文件。项目根目录可能有一个示例文件(如 config.example.yaml ),我们需要复制并修改它。
|
1 2 |
# 复制示例配置文件 copy config.example.yaml config.yaml |
用文本编辑器(如VSCode、Notepad++)打开 config.yaml 。我们需要重点关注 llm (大语言模型)和 embedding (文本嵌入模型)配置。
场景一:配置腾讯混元大模型API 腾讯混元提供了兼容OpenAI API的接口,这让我们可以像使用ChatGPT一样使用它。
|
1 2 3 4 5 6 7 |
llm: type: openai # 使用OpenAI兼容的客户端 model: hunyuan-lite # 模型名称,根据腾讯云控制台提供的名称填写,例如 hunyuan-lite, hunyuan-pro 等 api_key: "your-tencent-cloud-api-key" # 替换为你在腾讯云API密钥管理里创建的密钥 base_url: "https://hunyuan.tencent.com/v1" # 腾讯混元API的基础地址 api_version: "2024-07-01" # API版本,按腾讯云文档要求填写 timeout: 120 |
- api_key 获取 :你需要有一个腾讯云账号,在“腾讯混元”产品控制台申请开通,并创建API密钥。注意保管,不要泄露。
- base_url 和 api_version :这两个参数至关重要,必须严格按照腾讯云当前文档的说明填写。不同区域、不同版本的API地址可能不同,填错会导致连接失败。
场景二:配置本地Ollama模型 如果你在本地通过Ollama运行了模型(如 llama3.1:8b , qwen2.5:7b ),OpenClaw也可以直接调用。
|
1 2 3 4 5 6 |
llm: type: openai # 仍然是openai类型,因为Ollama也提供了OpenAI兼容的API model: llama3.1:8b # 你本地Ollama拉取的模型名称 api_key: "ollama" # Ollama的API通常不需要密钥,但有些客户端要求非空,可以随意填写一个字符串 base_url: "http://localhost:11434/v1" # Ollama默认的OpenAI兼容API地址 # api_version 字段对于Ollama通常不需要 |
- 前提 :确保Ollama服务已经在后台运行(你可以在浏览器访问 http://localhost:11434 看到Ollama的API文档页面)。
- base_url : 11434 是Ollama的默认端口, /v1 是OpenAI兼容端点。
嵌入模型配置 除了对话模型,OpenClaw的“记忆”等功能需要将文本转换为向量(嵌入)。对于本地部署,我们可以使用轻量级的本地嵌入模型,比如 BAAI/bge-small-zh-v1.5 。
|
1 2 3 4 5 6 7 |
embedding: type: huggingface # 使用HuggingFace模型 model_name: BAAI/bge-small-zh-v1.5 # 中文效果较好的小模型 model_kwargs: device: cpu # 如果没有GPU,就用cpu encode_kwargs: normalize_embeddings: true |
第一次运行时会从HuggingFace下载模型,请保持网络通畅。如果下载慢,可以尝试先在国内镜像站(如魔搭社区)下载模型文件,然后修改 model_name 为本地路径。
实操心得 :在 config.yaml 中,你可以配置多个LLM,并通过环境变量或代码指定使用哪一个。但最简单的方式是直接修改默认配置。建议先配置一个能通的(比如本地Ollama),确保基础流程跑通,再接入更复杂的云端API。
4. 启动与核心问题排查:直面“llama_index”的怒火
配置完成后,激动人心的启动时刻到了。在OpenClaw项目根目录下,运行:
|
1 |
python -m openclaw |
或者,如果项目提供了启动脚本:
|
1 |
python app.py |
大概率,你不会一次成功。下面是我遇到并解决的两个最具代表性的错误。
4.1 错误一:llama_index.core导入失败与版本降级
错误现象 :
|
1 |
ModuleNotFoundError: No module named 'llama_index.core' |
或者
|
1 |
AttributeError: module 'llama_index' has no attribute 'xxxx' |
根因分析 : llama-index 在0.10.x版本之后进行了重大的模块重构,将许多核心类从 llama_index 顶级包移动到了 llama_index.core 等子包。而OpenClaw的代码可能还停留在引用旧版本API的阶段。这就是为什么我们在环境准备时,要强制安装 llama-index<0.10.0 。
解决方案 :
- 首先检查已安装版本: pip list | findstr llama-index 。如果版本是0.10.x或更高,必须降级。
- 降级命令(在虚拟环境中):
这里我指定了一个经过测试可用的具体版本 0.9.48 。 --force-reinstall 会强制重新安装,即使已存在。1
pip install "llama-index==0.9.48" "llama-index-core==0.9.48" "llama-index-llms-openai==0.9.48" --force-reinstall
- 重新启动OpenClaw服务。
4.2 错误二:openai.APIConnectionError与网络代理配置
错误现象 : 当配置了腾讯混元或OpenAI的API后,启动服务或首次调用时出现:
|
1 |
openai.APIConnectionError: Connection error. |
或者更具体的SSL证书验证错误。
根因分析 :
- 网络问题 :你的机器无法直接访问 hunyuan.tencent.com 或 api.openai.com 。
- 代理冲突 :你的系统或终端设置了HTTP/HTTPS代理,但该代理无法正确转发请求到目标API,或者代理证书不被信任。
- 本地服务未启动 :对于Ollama,错误可能是 Connection refused ,这意味着Ollama服务根本没运行。
解决方案(分层排查) :
- 检查Ollama服务 :如果是本地模型,先在浏览器访问 http://localhost:11434 ,确认能看到Ollama的API页面。如果没有,去Ollama官网下载安装并启动服务。
- 测试API连通性 :写一个最简单的Python脚本测试连接。
在虚拟环境中运行这个脚本,它能最直接地暴露问题。1
2
3
4
5
6
7
8
9
10
11
12
13
14
import openai
client = openai.OpenAI(
api_key="your-api-key",
base_url="https://hunyuan.tencent.com/v1", # 或你的Ollama地址
)
try:
response = client.chat.completions.create(
model="hunyuan-lite",
messages=[{"role": "user", "content": "Hello"}],
timeout=10
)
print("连接成功!", response.choices[0].message.content)
except Exception as e:
print("连接失败:", e)
- 处理系统代理 :如果你使用了网络代理,需要为Python请求配置代理。
- 方法A(临时) :在启动OpenClaw前,在命令行设置环境变量。
1
2
3
set HTTP_PROXY=http://your-proxy:port
set HTTPS_PROXY=http://your-proxy:port
python -m openclaw
- 方法B(代码级) :在OpenClaw初始化OpenAI客户端的地方,传入 http_client 参数,使用配置了代理的 httpx.Client 。但这需要修改源码,不推荐新手。
- 更常见的情况是,你需要清除代理 :如果你不需要代理访问公网,请确保这些环境变量被清除。
在PowerShell中是 $env:HTTP_PROXY="" 。1
2
set HTTP_PROXY=
set HTTPS_PROXY=
- 方法A(临时) :在启动OpenClaw前,在命令行设置环境变量。
- 忽略SSL验证(最后手段,不安全) :仅在内网测试或确信环境安全时使用。可以在OpenAI客户端初始化时传入 http_client 参数,使用自定义的、关闭了SSL验证的HTTP客户端。 强烈不建议在生产环境或处理敏感信息时使用此方法。
当你看到服务成功启动,并输出监听地址(如 http://127.0.0.1:7860 或 http://localhost:8000 )时,恭喜你,最艰难的部分已经过去了。
5. 功能验证与基础使用:让Agent真正“动”起来
服务启动后,我们通常可以通过两种方式与OpenClaw交互:Web UI界面和API调用。
5.1 访问Web UI与基础对话
如果OpenClaw项目自带Web界面(例如基于Gradio或Streamlit),在启动日志中会给出一个本地URL,如 Running on local URL: http://127.0.0.1:7860 。在浏览器中打开这个地址。
- 选择模型 :在UI上,通常会有下拉菜单让你选择配置好的LLM(如果你配置了多个)。选择你配置好的“腾讯混元”或“本地Ollama”。
- 发起对话 :在聊天输入框发送一条消息,例如“介绍一下你自己”。
- 观察响应 :
- 如果成功,你会看到Agent的回复。第一次调用可能会慢一些,因为要加载嵌入模型和初始化。
- 如果失败,Web界面通常会返回错误信息。此时需要查看启动服务的命令行窗口,那里有更详细的错误日志(Traceback)。根据日志继续排查,常见问题包括API密钥错误、模型名称不对、额度不足等。
5.2 核心技能测试:工具调用与记忆
OpenClaw的强大之处在于其“技能”(Skills)系统,即Agent可以调用外部工具。一个经典的测试是“网络搜索”技能。
- 检查技能配置 :在 config.yaml 中,查找 skills 或 tools 配置部分。看看是否默认启用了 web_search 或类似技能。它可能需要额外的API Key(如SerpAPI或Google Search API)。
- 配置搜索API :如果你有SerpAPI的Key,在配置文件中填入。如果没有,可以暂时注释掉或禁用该技能,先测试纯对话。
- 测试工具调用 :在Web UI中,尝试问一个需要实时信息的问题,比如“今天北京天气怎么样?”。如果技能配置正确,你应该能在回复中看到Agent尝试调用搜索工具的日志,并(如果API有效)返回搜索结果摘要。
- 测试记忆 :进行一个多轮对话。先问“我叫张三”,再问“我的名字是什么?”。一个具备记忆能力的Agent应该能回答“张三”。这验证了其“对话历史”或“向量记忆”功能是否正常工作。
避坑提示 :很多技能依赖第三方API,免费额度可能有限。在测试时,先确认技能所需的API服务是否可用、Key是否正确、额度是否充足。建议从不需要外部API的纯对话和本地工具(如计算器、读文件)开始测试。
6. 进阶配置与优化:打造更实用的本地Agent
基础服务跑通后,我们可以进行一些优化,让它更稳定、更好用。
6.1 模型切换与负载均衡
在 config.yaml 中,你可以定义多个LLM配置,并给它们起名字。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
llms: hunyuan: type: openai model: hunyuan-lite api_key: ${TENCENT_API_KEY} base_url: "https://hunyuan.tencent.com/v1" ollama-llama: type: openai model: llama3.1:8b api_key: “ollama” base_url: "http://localhost:11434/v1" ollama-qwen: type: openai model: qwen2.5:7b api_key: “ollama” base_url: "http://localhost:11434/v1" |
然后,在代码或环境变量中指定默认使用的LLM。更高级的用法是编写一个简单的路由逻辑,根据查询类型、复杂度或负载情况自动选择模型。例如,简单中文问答用混元,复杂推理用本地Llama,代码生成用Qwen。
6.2 嵌入模型本地化与加速
前面我们用了HuggingFace的在线嵌入模型,每次启动都会检查更新,且受网络影响。我们可以将其完全本地化。
- 下载模型文件 :使用 git lfs 或直接从HuggingFace镜像站(如魔搭ModelScope)下载 BAAI/bge-small-zh-v1.5 的整个模型文件夹。
- 修改配置 :将 embedding 配置中的 model_name 改为本地绝对路径。
1
2
3
4
5
6
7
embedding:
type: huggingface
model_name: D:/models/bge-small-zh-v1.5 # 你的本地路径
model_kwargs:
device: cpu
encode_kwargs:
normalize_embeddings: true
- 考虑使用更快的本地嵌入模型 : bge-small 在CPU上速度尚可,但如果处理大量文档,速度仍是瓶颈。可以尝试更小的模型,如 paraphrase-multilingual-MiniLM-L12-v2 ,或在有GPU的情况下指定 device: cuda 。
6.3 持久化存储与记忆管理
OpenClaw的对话记忆和知识库索引默认可能放在内存中,服务重启就丢失。我们需要配置持久化存储。
- 向量数据库 :这是存储和检索记忆(向量)的关键。OpenClaw可能默认使用简单的本地存储(如 SimpleVectorStore )。我们可以换成更持久化的后端,比如 Chroma 或 Qdrant 。
- 安装Chroma: pip install chromadb
- 在配置中,将向量存储指向一个本地目录。具体配置参数需要查阅OpenClaw和Chroma的文档。
- 对话历史存储 :确保对话历史被保存到文件或数据库中,而不是仅存在于当前会话。这通常需要在初始化Agent时,传入一个持久化的 ChatHistory 对象。
这些进阶配置需要你阅读OpenClaw的源码和文档,了解其内部的数据流和存储接口。虽然有一定复杂度,但这是将Demo转化为可用工具的关键一步。
7. 开发调试与自定义技能扩展
当你熟悉了OpenClaw的基本运行后,很可能会想定制它,比如增加一个处理Excel文件的技能,或者连接你的内部知识库。
7.1 日志与调试技巧
高效的调试能节省大量时间。
- 开启详细日志 :在启动命令前设置环境变量,让 openai 库和 httpx 库输出详细日志。
这会在控制台打印出每次API请求的URL、头部和响应,对于排查网络和参数问题极有帮助。1
2
3
set OPENAI_LOG=debug
set HTTPX_LOG_LEVEL=debug
python -m openclaw
- 使用Debugger :在可能出错的代码行前加上 import pdb; pdb.set_trace() ,启动服务后,当执行到该行时会进入交互式调试器,可以逐行检查变量状态。
- 单元测试 :为你的自定义技能编写简单的单元测试,隔离问题。
7.2 编写一个简单的自定义技能
OpenClaw的技能本质上是符合其工具调用规范的Python函数。假设我们要添加一个“计算阶乘”的技能。
- 找到技能目录 :在OpenClaw源码中,通常有一个 skills/ 或 tools/ 目录。在里面创建一个新文件 my_math_tools.py 。
- 编写技能函数 :
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
from typing import Any
from pydantic import BaseModel, Field
# 定义工具的输入参数模型
class FactorialInput(BaseModel):
n: int = Field(..., description="The integer to compute factorial for, must be >= 0.")
# 工具函数本身
def calculate_factorial(n: int) -> int:
"""Calculate the factorial of a non-negative integer n."""
if n < 0:
raise ValueError("n must be non-negative")
result = 1
for i in range(2, n + 1):
result *= i
return result
# 暴露给Agent的接口函数,需要符合框架要求的格式
def factorial_tool(args: FactorialInput) -> dict[str, Any]:
n = args.n
try:
result = calculate_factorial(n)
return {"success": True, "result": result, "message": f"The factorial of {n} is {result}."}
except Exception as e:
return {"success": False, "message": f"Error: {e}"}
# 工具的元数据,用于让LLM理解何时调用此工具
FACTORIAL_METADATA = {
"name": "calculate_factorial",
"description": "Calculate the factorial of a given non-negative integer.",
"args_schema": FactorialInput, # 关联参数模型
"function": factorial_tool, # 关联执行函数
}
- 注册技能 :在框架加载技能的地方(可能是一个 __init__.py 或专门的注册文件),导入你的 FACTORIAL_METADATA 并将其添加到全局工具列表中。
- 测试技能 :重启OpenClaw服务,然后在对话中尝试“请计算5的阶乘”。Agent应该能识别出意图,调用你的工具,并返回结果“120”。
这个过程的关键在于理解框架如何定义、注册和调用工具。多参考现有的技能代码(如 web_search.py , calculator.py )是快速上手的最佳途径。
走完以上所有步骤,你应该已经拥有了一个在Windows上稳定运行、可根据需要接入云端或本地模型、并具备一定扩展能力的OpenClaw AI Agent环境。整个过程的精髓不在于一次成功,而在于遇到问题时,能根据错误信息,结合对系统组件(Python环境、依赖包、网络、配置文件、模型服务)的理解,进行有条理的排查。这份指南提供的正是这样一套从“地基”到“封顶”的完整建造与排障逻辑。