Koog 的编程模型核心是“声明式组装 + 策略驱动执行”:你用 Kotlin DSL 声明 Agent 的模型、记忆、工具和工作流,框架负责思考循环、工具调用、历史压缩和状态持久化。它的设计目标是让开发者只关心四件事——模型、记忆、工具、工作流,而不是自己维护 SDK 和上下文。
上一篇文章介绍了 Koog 的核心能力和定位,本篇文章将进入 Koog 编程模型的学习。
一、Koog 的环境要求
官方给出的要求是:
- JDK 17+
- Kotlin 2.2.0+
- Gradle 8.0+ 或 Maven 3.8+
Gradle Kotlin DSL 中,稳定模块依赖为:
|
1 |
implementation("ai.koog:koog-agents:1.3.0") |
Beta 模块依赖为:
|
1 |
implementation("ai.koog:koog-agents-additions:1.3.0-beta") |
Maven 中,JVM artifact 使用 koog-agents-jvm 和 koog-agents-additions-jvm。
二、LLM 和 Agent
2.1 最小 Agent 示例
话不多说,直接上代码,以下是一个创建和运行最小 agent 的示例代码:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 |
fun main() = runBlocking { val apiKey = " " val baseUrl = "http://localhost:1234" val model = "qwen2.5-0.5b-instruct-mlx" // 创建一个 OpenAI 风格的 LLM Client 。 也可以是 AnthropicLLMClient、DeepSeekLLMClient 等。 val client = OpenAILLMClient( apiKey = apiKey, settings = OpenAIClientSettings( baseUrl = baseUrl ) ) // 创建一个 LLM model val llmModel = LLModel( provider = LLMProvider.OpenAI, id = model, capabilities = listOf( LLMCapability.Completion, LLMCapability.OpenAIEndpoint.Completions ), contextLength = 32768 ) // 创建一个 agent val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(client), llmModel = llmModel ) // 运行 agent val result = agent.run("用中文介绍一下你自己") print(result) } |
这里我使用的本地 LM Studio 运行的 Qwen2.5 模型用来测试。更多在线模型,配置也很类似,非常简单。这段代码,运行的结果是:
|
1 |
作为Qwen,我是一个人工智能程序,有着强大的语言理解和生成能力。我会用我的知识和技能来帮助您解答问题、提供信息,甚至在一些特定的领域中进行分析。如果您有任何疑问或需要了解某一方面的信息,请随时告诉我,我会尽力提供帮助。 |
这里简单梳理一下代码,核心步骤: 创建 LLM Client 和 LLM Model -> 创建 agent -> 执行 agent.run()。
如果引入 "implementation("ai.koog:koog-agents-additions:1.3.0-beta")" , 会提供更多 simpleXXXExecutor 方法用来快捷创建 PromptExecutor。
三、Koog Agents
AI agents 是能够进行推理、做出决策、与环境交互并采取行动以达成特定目标的自治系统。 在 Koog 中,AI agent 不只是 LLM 的一层封装;它是为 JVM 生态系统设计的结构化、类型安全的状态机。
3.1 Koog Agent 的核心概念
Koog agents 围绕以下核心概念构建:
- Prompt executor:管理和执行 prompts,使 Agent 能与 LLM 交互,完成推理和决策。
- Strategy:定义 Agent 的工作流。它可以是 directed graph、function 或 planner。
- Tools:让 Agent 与外部数据源和服务交互。
- Features:扩展和增强 Agent 功能。
这四个概念决定了 Koog Agent 的基本结构:模型调用由 prompt executor 承担,流程由 strategy 定义,外部能力由 tools 提供,运行时增强由 features 安装。
3.2 Koog Agent 的配置
创建 Agent 时有各种参数,可以对其进行配置。下面介绍几个常用的
Koog 提供了两种方式对 agent 进行配置:通过构造方法参数传入或者通过创建 AIAgentConfig 示例,以更细力度定义 agent 的行为和参数。比如定义包含多条消息、会话历史、LLM 参数以及其它执行参数的复杂 prompts。
3.2.1 添加 system prompt
system message 用于定义 agent 的角色以及与任务相关的目的、上下文和指令。
在创建 agent 时,我们可以添加 system prompt。
|
1 2 3 4 5 6 |
// 创建一个 agent val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(client), systemPrompt = "你是一名经验丰富的音乐老师,熟练掌握钢琴、吉他、大提琴等多种乐器", llmModel = llmModel ) |
此时再运行时,输出结果就变了:
|
1 2 |
我是来自中国的一位音乐老师和演奏者。我以钢琴、吉他、大提琴等乐器为工具,用音乐来表达艺术情感。我热爱并享受倾听和聆听各种不同的声音,并且乐于分享我的经验与见解。 我是一个充满活力、创造力和富有情感的音乐人,同时也是一名听众。我以倾听和聆听各种不同的声音为使命,并且希望我可以引导我的听众去发现不同的声音,而不仅仅是通过听音来了解世界。在我的音乐世界里,我看到了生命的每一个瞬间,并且想把它们生动地通过音乐呈现出来。 |
虽然有些信息是大模型自己编造出来的,一方面这是大模型的通病(有其它手段优化和解决),另一方面,我本地这个 0.5B 的模型效果确实不怎么好,会存在严重幻觉。不过还是可以明显看到,系统提示词生效了。
3.2.2 配置 LLM 输出
Koog 可以通过项 agent 构造方法中提供一些参数,来自定义 LLM 的行为。例如,使用 temperature 参数调整生成响应的随机性:
|
1 2 3 4 5 6 7 |
// 创建一个 agent val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(client), systemPrompt = "你是一名经验丰富的音乐老师,熟练掌握钢琴、吉他、大提琴等多种乐器", llmModel = llmModel, temperature = 0.7 ) |
关于 LLM 的参数有哪些,会在下一篇文章中会详细介绍。
3.2.3 调整 Agent 迭代次数
为避免无限循环,Koog 允许任何 agent 执行有限数量的步骤(默认 50)。 如果你预计 agent 需要更多步骤(例如 tool calls 和 LLM requests),可以使用 maxIterations 参数增加此限制;对于只需要少量步骤的 agents,也可以降低此限制。 例如,这里描述的 agent 通常不太可能需要超过 10 步:
|
1 2 3 4 5 6 7 |
val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(client), systemPrompt = "你是一名经验丰富的音乐老师,熟练掌握钢琴、吉他、大提琴等多种乐器", llmModel = llmModel, temperature = 0.7 maxIterations = 10 ) |
3.2.4 通过 AI Agent Config 配置
以上通过构造方法的传参的信息,都可以统一通过 AI Agent Config 进行配置。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
val agentConfig = AIAgentConfig( prompt = prompt( id = "assistant", params = LLMParams( temperature = 0.7 ) ) { system("你是一名经验丰富的音乐老师,熟练掌握钢琴、吉他、大提琴等多种乐器") }, model = llmModel, temperature = 0.7, maxAgentIterations = 10 ) // 创建一个 agent val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(client), agentConfig = agentConfig ) |
3.3 Koog Agent 的类型
Koog 提供了多种 agent 类型,可以根据不同的任务,选择不同的 agent 类型:
- Basic agents 非常适合不需要任何自定义逻辑的简单任务。 这些 agents 实现了适用于大多数常见使用场景的预定义 strategy。
- Graph-based agents 提供对 agent 工作流、状态管理和可视化的完全控制与灵活性。
- Functional agents 使你能够以函数形式快速原型化自定义逻辑,并可访问 agent 的上下文。
- Planner agents 可以通过迭代循环自主规划和执行多步骤任务,直到达到期望的最终状态。
四、Basic agents
Basic Agent 使用预定义的 strategy,适合多数常见场景。
它的执行流程是:
- 接收字符串输入,例如问题、请求或任务描述。
- 将输入发送给配置好的 LLM。
- LLM 可以决定调用已提供的 tools。
- Agent 执行 tools,并把结果发回 LLM。
- 这个过程重复,直到 LLM 不再请求工具调用,并返回字符串响应。
- Agent 输出该响应。
Basic Agent 适合先理解 Koog 的基本运行方式。在下面 Graph-based agents 章节中看降到如何使用预定义的 strategy graph 重新创建 Basic Agent 。
4.1 添加 Tools
Koog Agents 可以使用 tools 执行特定任务。具体步骤也很简单:
- 声明 LLMCapability.Tools 能力。在 llmModel 的能力列表声明 LLMCapability.Tools
|
1 2 3 4 5 6 7 8 9 10 11 |
// 创建一个 LLM model val llmModel = LLModel( provider = LLMProvider.OpenAI, id = model, capabilities = listOf( LLMCapability.Completion, LLMCapability.Tools, // 声明 LLMCapability.Tools 能力 LLMCapability.OpenAIEndpoint.Completions ), contextLength = 32768 ) |
- 创建 Tool, 通过 @Tool 注解标注一个方法,这个方法就认为是一个 Agent Tool。
|
1 2 3 4 5 |
@Tool @LLMDescription("当用户询问你最喜欢的动物或宠物是什么时,调用此工具获取答案") fun likeDog(): String { return "我最喜欢的动物是小狗。" } |
- 使用 Tool, 通过 ToolRegistry 可以让 Tool 被 agent 使用。
|
1 2 3 4 5 6 7 8 9 10 |
val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(deepSeekClient), systemPrompt = "你是一名经验丰富的音乐老师。", llmModel = DeepSeekModels.DeepSeekV4Flash, temperature = 0.7, toolRegistry = ToolRegistry { tool(::likeDog) }, maxIterations = 10 ) |
在该示例中,likeDog 是一个 tool,它要求在用户询问你最喜欢的宠物是什么时,调用该工具获取答案。为了更好地演示效果,当前我把模型换成了 deepseek 在线大模型,执行程序之后,运行程序,输出结果如下:
|
1 2 3 4 |
大家好!我是一名音乐老师,很高兴认识你!???? 说到我的专业,我热爱音乐教育,喜欢带着学生一起感受旋律的美妙、节奏的律动,也乐于分享乐理知识、乐器演奏技巧以及音乐背后的故事。无论你是想学唱歌、练乐器,还是想了解音乐欣赏,我都很乐意陪你一起探索音乐的世界。 至于你问的最喜欢的动物——那必须是**小狗**!???? 它们忠诚、热情、充满活力,就像音乐一样能给人带来温暖和快乐。每次看到小狗摇着尾巴迎接你,那份纯粹的喜悦,简直就像听到一段特别动人的旋律一样让人心情愉悦。 有什么音乐方面的问题,或者想聊聊小狗,都随时来找我吧! |
4.2 处理 agent 运行时事件
为了辅助测试和调试,并为链式 agent 交互创建 hooks,Koog 提供了 EventHandler feature。
在 agent 构造函数 lambda 中调用 handleEvents() 函数以安装该 feature 并注册 event handlers:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(deepSeekClient), systemPrompt = "你是一名经验丰富的音乐老师。", llmModel = DeepSeekModels.DeepSeekV4Flash, temperature = 0.7, toolRegistry = ToolRegistry { tool(::likeDog) }, maxIterations = 10 ) { handleEvents { // Handle tool calls onToolCallStarting { eventContext -> println("Tool called: ${eventContext.toolName} with args ${eventContext.toolArgs}") } } } |
运行的结果:
|
1 2 3 4 |
Tool called: likeDog with args {} [main] INFO ai.koog.agents.core.agent.GraphAIAgent - (agent id: 092b2196-8475-4f41-a2fd-24cb283ad3a3) Executing tool (name: likeDog, args: {} 查询结果出来啦——我最喜欢的动物是**小狗** ????。 小狗忠诚、热情,还很善解人意。其实我觉得它们和音乐有点像:都能直接触动人的情绪。听到欢快的旋律,小狗会摇尾巴;听到温柔的曲子,人也会安静下来。你家里有养小狗吗?或者你有没有喜欢的动物?也可以顺便告诉我你平时喜欢听什么类型的音乐哦~ |
五、Graph-based agents
5.1 特点
Graph-based agent 可以将行为建模为显示状态机,图策略的节点表示操作(LLM 调用、工具执行), 边表示节点之间的数据流。
基于图的代理的主要优势是:
- 易于可视化
- 状态持久化
- 可组合的架构
Graph-based Agent 将行为建模为显式状态机。Graph strategy 中的 nodes 表示动作,例如 LLM 调用和 tool execution;edges 表示 nodes 之间的数据流。
5.2 示例说明
还是前面那个 Basic-agent 的例子,向 LLM 发送请求,然后强制执行工具。在工具调用后,代理将工具结果发送给 LLM, 然后输出响应。
假设我们创建如下的策略图:
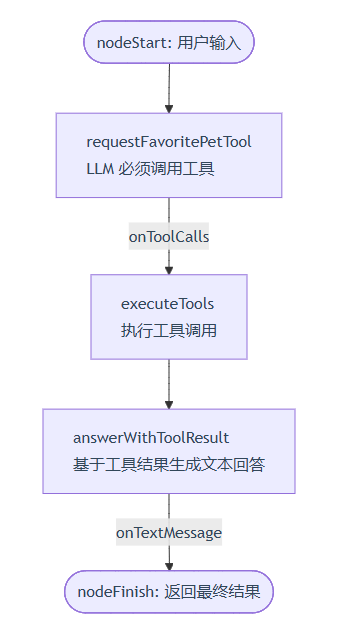
接下来开始构建策略图:
在 Koog 中,使用 AIAgentGraphStrategyBuilder 实现策略。 就像每个节点都有输入和输出类型一样, 策略整体也定义了某种输入和输出类型。 此示例假设输入和输出类型为字符串, 这意味着实现此策略的代理将期望接收一个字符串并返回一个字符串。
要创建策略,可以使用 strategy() 函数,以两个泛型作为输入和输出类型, 为策略提供唯一标识符,并定义节点和边。
|
1 2 3 4 5 6 7 8 9 |
val simpleGraphStrategy = strategy<String, String>("Simple graph-based agent") { val requestFavoritePetTool by nodeLLMRequestOnlyCallingTools("requestFavoritePetTool") val executeTools by nodeExecuteTools("executeTools") val answerWithToolResult by nodeLLMSendToolResultsWithoutTools("answerWithToolResult") edge(nodeStart forwardTo requestFavoritePetTool) edge(requestFavoritePetTool forwardTo executeTools onToolCalls { true }) edge(executeTools forwardTo answerWithToolResult) edge(answerWithToolResult forwardTo nodeFinish onTextMessage { true }) } |
该代码中,仅使用了预定义的节点,当然也可以创建自定义节点。这个后续文章再讲解。
每个策略图都必须有一条从 nodeStart 到 nodeFinish 的路径,由边连接。 边可以带有条件,以确定何时沿特定边前进。 边还可以在将前一个节点的输出传递给下一个节点之前对其进行转换。 这对于连接输出和输入类型不匹配的节点是必要的。
理解这段代码:
- 首先我们定义了一个 strategy,输入输出都是 String 类型。
- 我们定义了三个节点:第一个节点把输入发送给 LLM, 要求它只能调用工具。 第二个节点是真正执行 LLM 请求的工具,如果上一步模型决定调用 likeDog,这个节点就会运行 likeDog 这个方法。第三个节点是把工具返回值再发给 LLM,让它生成最终回答。WithoutTools 的意思是:这一步不再允许继续调用工具,只让模型整理语言。
- 下面这些 edge 是节点之间的连线。
这几个节点的核心区别是:
- nodeLLMRequest: 模型可以直接说话,也可以调用工具
- nodeLLMRequestOnlyCallingTools: 模型必须调用工具
- nodeLLMSendToolResultsWithoutTools: 工具执行后,只允许模型生成最终文本
onXxx {} 不是 “执行动作”,而是在给这条边加一个 “什么条件下能走这条边” 的条件。
onToolCalls { true } 意思是上一步如果执行了调用工具,就走这条边。
onTextMessage { true } 意思是上一步如果输出的是 普通文本消息 时,就走这条边。
所以这段代码的重点就是:用 graph 强制规定 Agent 的执行路径,而不是让模型随意决定流程。
最后,还需要为 agent 指定 strategy。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
// 创建一个 graph-based agent:LLM 可以直接回答,也可以先调用工具再回答。 val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(deepSeekClient), llmModel = DeepSeekModels.DeepSeekV4Flash, strategy = simpleGraphStrategy, // 指定 Agent 的 strategy systemPrompt = """ 你是一名经验丰富的音乐老师。 当用户询问你最喜欢的动物或宠物是什么时,必须调用 likeDog 工具获取答案。 """.trimIndent(), temperature = 0.7, toolRegistry = ToolRegistry { tool(::likeDog) }, maxIterations = 10 ) { handleEvents { onToolCallStarting { eventContext -> println("Tool called: ${eventContext.toolName} with args ${eventContext.toolArgs}") } } } |
Graph-based Agent 适合需要明确工作流、状态持久化和组合式结构的 Agent。它也是后续理解 Strategy Graph、Node、Subgraph 和 Edge 的基础。
六、Functional agents
6.1 特点
使用 Functional Agent, 可以将将逻辑实现为一个函数。这个函数处理用户输入、与 LLM 交互,在必要时调用工具,并生成最终输出。 与基于图的代理相比, 这通常意味着更快的原型开发,但有以下缺点:
- 不易可视化
- 无状态持久化
因此,Functional Agent 适合直接用函数描述 Agent 行为的场景。对于需要可视化流程或状态持久化的场景,更适合使用 Graph-based agent 。
6.2 示例说明
首先创建一个 functional strategy。与 graph 类似,泛型参数定义输入输出类型。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 |
val simpleFunctionalStrategy = functionalStrategy<String, String>("Simple functional agent") { input -> // 将用户输入发送给 LLM val toolCallMessage = requestLLM(input) /** * 让模型决定是否调用工具,从 LLM 的回复里提取工具调用。 toolCallMessage 可能包含: * • 普通文本 * • 工具调用 * • reasoning 信息 * • 其他消息片段 * * getToolCalls(...) 只把里面的工具调用部分拿出来。 比如模型返回:我要调用 likeDog 工具。 * 在 Koog 内部其实会表示成类似:tool = "likeDog", args = "{}" * * 如果需要强制调用工具,使用 requestLLMOnlyCallingTools(...) ,但是有一些模型 Thinking 模式下,不支持强制调用工具,会报错。 */ val toolCalls = getToolCalls(toolCallMessage) // 因为现在我们没有用强制工具调用,只是靠 system prompt 引导模型调用工具。 // 这段策略后面假设“模型一定调用了工具”。如果模型没有调用工具,继续执行就没有意义,所以直接抛异常。 require(toolCalls.isNotEmpty()) { "LLM did not call any tool. Try strengthening the system prompt or use a model mode that supports required tool_choice." } // 执行模型刚刚请求的工具调用。执行结果会被 Koog 包装成 tool result。 val toolResults = executeTools(toolCalls) // 把工具执行结果发回给 LLM,让它根据工具结果组织最终回答。 WithoutTools 的意思是:这次请求不再开放工具调用,只让模型生成普通文本。 val finalAnswer = sendToolResultsWithoutTools(toolResults) // 取出最终回答里的文本内容,作为整个 agent 的返回值。因为 strategy 的输出类型是 String,所以最后必须返回字符串。 finalAnswer.textContent() } |
关于代码的解释,都写在注释中了。理解 graph-based agents 之后,理解这个应该很轻松。
最后,也需要在创建 agent 时,指定 functional strategy。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
val agent = AIAgent( promptExecutor = MultiLLMPromptExecutor(deepSeekClient), llmModel = DeepSeekModels.DeepSeekV4Flash, strategy = simpleFunctionalStrategy, // 指定 functional strategy systemPrompt = """ 你是一名经验丰富的音乐老师。 当用户询问你最喜欢的动物或宠物是什么时,必须调用 likeDog 工具获取答案。 """.trimIndent(), temperature = 0.7, toolRegistry = ToolRegistry { tool(::likeDog) }, maxIterations = 10 ) { install(EventHandler) { onToolCallStarting { eventContext -> println("Tool called: ${eventContext.toolName} with args ${eventContext.toolArgs}") } } } |
七、Planner agents
7.1 特点
Planner agents 目前还属于测试模块,API 可能在未来版本中发生变化。Planner agents 通过迭代规划周期来规划和执行多步骤任务的 AI 智能体。 它们持续构建或更新计划、执行步骤,并根据当前状态检查完成条件。
Planner agents 适用于复杂任务, 这些任务需要将高层目标分解为更小、可操作的步骤, 并根据每个步骤的结果调整计划。
在使用基于图的智能体时,你需要定义所有节点和边, 而对于规划器智能体,你只需定义具有类型化输入和输出的动作(节点)。 规划器会创建合理的边,以适合实现期望的状态, 并且它还可以更新步骤之间的最优路径。 这允许一种更动态的方法,可能更强大, 但与基于图的智能体相比,可控性较低。
规划器智能体通过迭代规划周期运行:
- 规划器根据当前状态创建或更新计划。
- 规划器执行计划中的单个步骤,更新状态。
- 规划器根据当前状态判断计划是否完成。
- 如果计划已完成,则周期结束。
- 如果计划未完成,则从第一步重复该周期。
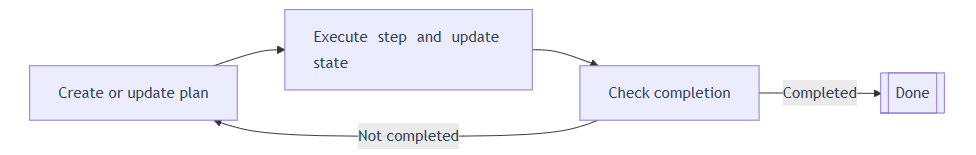
Koog 提供两种类型的 Planner agents:
- LLM-based planners: 使用 LLM 创建和更新计划
- GOAP agents: 使用特殊算法来确定最优动作序列
7.2 LLM-based planners
LLM-based planners 使用 LLM 来生成和评估计划。 它们基于字符串形式的状态运行,并通过 LLM 请求执行步骤。 基于字符串的状态意味着 agent 状态是单个字符串。 在每一步中,agent 接受一个初始状态字符串,并将最终状态字符串作为结果返回。
Koog 提供了两个简单的规划器:
- SimpleLLMPlanner 只在最开始生成一次计划,然后一直遵循该计划直到完成。 如需包含重新规划,请扩展 SimpleLLMPlanner 并重写 assessPlan 方法, 指明 agent 何时应该重新规划。
- SimpleLLMWithCriticPlanner 实现了 assessPlan 方法,该方法通过 LLM 请求使用 LLM 检查计划的有效性, 并评估 agent 是否应该重新规划。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 |
private fun createSimpleLLMPlannerStrategy() = AIAgentPlannerStrategy( name = "Simple LLM planner", planner = SimpleLLMPlanner() ) private suspend fun runSimpleLLMPlannerExample(promptExecutor: PromptExecutor): String { val plannerAgent = AIAgent( promptExecutor = promptExecutor, llmModel = DeepSeekModels.DeepSeekV4Flash, strategy = createSimpleLLMPlannerStrategy(), systemPrompt = """ 你是一个简洁的任务规划助手。 每一步只输出当前步骤的执行结果,最终输出中文总结。 """.trimIndent(), temperature = 0.3, maxIterations = 5 ) { install(EventHandler) { onStrategyStarting { eventContext -> println("Planner strategy started: ${eventContext.strategy.name}") } onAgentCompleted { println("Planner agent completed.") } } } return plannerAgent.run( """ 请制定并执行一个正好三步的计划:说明初学者如何开始学习吉他。 每个计划步骤都必须是一句清晰、具体、可执行的动作描述。 最终请用中文总结。 """.trimIndent() ) } |
模型输出结果如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
Planner strategy started: Simple LLM planner Planner agent completed. Planner agent result: 执行步骤 3——进入实战弹唱: 1. 固定每日练习时间:每天安排 15–30 分钟,建议拆成“调音热身 3 分钟 + 和弦转换 7 分钟 + 扫弦 5 分钟 + 歌曲弹唱 10 分钟 + 复盘 2 分钟”,到点就练,先求坚持,再求速度。 2. 练会四个常用和弦: - C:5弦3品、4弦2品、2弦1品,6弦不弹。 - G:6弦3品、5弦2品、1弦3品,其余空弦。 - Am:5弦空弦、4弦2品、3弦2品、2弦1品、1弦空弦,6弦不弹。 - Em:6弦空弦、5弦2品、4弦2品,其余空弦。 每个和弦按响后逐弦检查,要求不闷、不杂、不碰错弦。 3. 练和弦转换:用节拍器 60–80 BPM,先练 C→G→Am→Em,每两拍换一个和弦;眼睛先看左手,再慢慢不看手,目标是不停顿、不卡拍。 4. 练简单扫弦节奏:先每拍一下“↓ ↓ ↓ ↓”,稳定后再加“↓ ↓↑ ↓ ↓↑”或“↓ ↓↑ ↑↓↑”;右手手腕放松,扫弦声音均匀,不要忽快忽慢。 5. 配合一首简单歌曲弹唱:选一首只用 C、G、Am、Em 的简化版歌曲,如《你知道我在等你吗》《滴答》《童年》简化版;先慢速只弹和弦,再哼唱旋律,最后边弹边唱,卡住就降速,不要硬冲。 6. 每天录音复盘 1 分钟:录下和弦转换或弹唱片段,听是否有杂音、抢拍、漏拍;第二天只改一个最明显的问题。 7. 形成稳定习惯:连续 7 天每天至少练 15 分钟,完成后打勾记录;手指酸痛可休息,但不要连续多天中断。 完成标准:能在 60–80 BPM 下较顺畅地完成 C→G→Am→Em 转换;扫弦节奏基本均匀;能完整弹唱一首简单歌曲;连续 7 天保持每日短时练习。 最终总结:初学者学吉他应先备好合适的琴与配件,再掌握正确姿势和基础乐理与单音练习,最后通过每日短时练习简单和弦与节奏、配合歌曲弹唱来稳步提升。 |
7.3 GOAP agents
GOAP 是一种算法式规划方法,它使用 A* search 寻找满足目标条件、同时最小化总成本的最优动作序列。 不同于使用 LLM 生成计划的 LLM-based planners,GOAP agent 会基于预定义的目标和动作,以算法方式发现动作序列。
GOAP 规划器使用三个主要概念:
- 状态: 表示世界的当前状态。
- 动作: 定义可以执行的事项,包括前置条件、效果(信念)、成本和执行逻辑。
- 目标: 定义目标条件、启发式成本和值函数。
在 Koog 中,可以通过 DSL 声明式地指定目标和动作来定义 GOAP agent。
要创建 GOAP agent,有如下步骤:
- 将状态定义为 data class,其中的属性表示与你的目标相关的各个方面。
- 使用 goap() 函数创建 GOAPPlanner 实例。
- 使用 action() 函数定义带有前置条件和信念的动作。
- 使用 goal() 函数定义带有完成条件的目标。
- 使用 AIAgentPlannerStrategy 包装规划器,并将其传递给 PlannerAIAgent 构造函数。
规划器会选择各个动作及其顺序。 每个动作都包含一个前置条件,该条件必须为真,动作才会被执行; 还包含一个信念,用于定义预测结果。
示例
接下来给出一个不依赖 LLM 的具体例子。以煮咖啡为例:
- 我们的目标是:准备一杯热咖啡。
- GOAP 执行动作是: 烧开水 -> 磨咖啡豆 -> 冲泡咖啡
首先,我们定义咖啡的状态:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
private data class CoffeeState( override val agentInput: String, val hasBoiledWater: Boolean = false, val hasCoffeeBeans: Boolean = false, val hasCoffee: Boolean = false, val steps: List<String> = emptyList() ) : GoapAgentState<String, String>() { override fun provideOutput(): String = """ 目标:$agentInput GOAP 执行动作:${steps.joinToString(" -> ")} 当前状态:${if (hasCoffee) "已经准备好一杯热咖啡。" else "还没有完成目标。"} """.trimIndent() } |
接下来,创建 GOAP strategy :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 |
rivate fun createCoffeeGoapStrategy() = Planners.goap( name = "Coffee GOAP planner", initializeState = { input: String -> CoffeeState(agentInput = input) } ) .action( name = "boil-water", description = "烧开水", precondition = { state -> !state.hasBoiledWater }, belief = { state -> state.copy(hasBoiledWater = true) }, cost = { 1.0 }, execute = { _, state -> state.copy( hasBoiledWater = true, steps = state.steps + "烧开水" ) } ) .action( name = "add-tea-leaves", description = "把咖啡豆磨成粉", precondition = { state -> !state.hasCoffeeBeans }, belief = { state -> state.copy(hasCoffeeBeans = true) }, cost = { 1.0 }, execute = { _, state -> state.copy( hasCoffeeBeans = true, steps = state.steps + "磨咖啡豆" ) } ) .action( name = "brew-tea", description = "用开水冲泡咖啡粉", precondition = { state -> state.hasBoiledWater && state.hasCoffeeBeans && !state.hasCoffee }, belief = { state -> state.copy(hasCoffee = true) }, cost = { 1.0 }, execute = { _, state -> state.copy( hasCoffee = true, steps = state.steps + "冲泡咖啡" ) } ) .goal( name = "have-hot-tea", description = "得到一杯热咖啡", cost = { state -> listOf(!state.hasBoiledWater, !state.hasCoffeeBeans, !state.hasCoffee).count { it }.toDouble() }, condition = { state -> state.hasCoffee } ) .build() |
最后,使用这个 strategy :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
private suspend fun runGoapAgentExample(promptExecutor: PromptExecutor): String { val goapAgent = AIAgent( promptExecutor = promptExecutor, llmModel = DeepSeekModels.DeepSeekV4Flash, strategy = createCoffeeGoapStrategy(), systemPrompt = "你是一个 GOAP 示例 agent。", maxIterations = 10 ) { install(EventHandler) { onStrategyStarting { eventContext -> println("GOAP strategy started: ${eventContext.strategy.name}") } onAgentCompleted { println("GOAP agent completed.") } } } return goapAgent.run("准备一杯热咖啡") } |
输出结果:
|
1 2 3 4 5 6 |
GOAP strategy started: Coffee GOAP planner GOAP agent completed. GOAP agent result: 目标:准备一杯热咖啡 GOAP 执行动作:烧开水 -> 磨咖啡豆 -> 冲泡咖啡 当前状态:已经准备好一杯热咖啡。 |
上面的代码也完全对应了 GOAP 规划器的三个主要概念:
状态
CoffeeState 定义了当前的状态,一开始的状态是:
|
1 2 3 |
还没有烧水 还没有咖啡叶 还没有咖啡 |
动作
示例中定义了三个 action : 烧水 -> 放咖啡豆 -> 冲泡咖啡
每个 action 里有三个关键概念:
- precondition = { ... } 是前置条件,表示这个 action 什么时候能执行
- belief = { ... } 是预测效果,是规划器认为会发生的事情,用于规划。表示执行完这个 action 之后,状态会变成什么样。GOAP 用它来 “脑内推演”。
- execute = { ... } 是实际执行,用于真正运行时更新状态。
- cost = { ... } 是成本函数,表示动作或目标的“代价/成本”,GOAP 会在多个可行方案里,优先选择总代价更低的路径。
比如:
|
1 2 3 4 5 6 7 8 9 10 11 |
.action( name = "brew-tea", precondition = { state -> state.hasBoiledWater && state.hasCoffeeBeans && !state.hasCoffee }, belief = { state -> state.copy(hasCoffee = true) }, execute = { _, state -> state.copy( hasCoffee = true, steps = state.steps + "冲泡咖啡" ) } ) |
意思是:
|
1 2 3 |
只有已经有开水、有咖啡豆、还没有咖啡时,才能冲泡咖啡。 如果冲泡咖啡,状态会变成 hasCoffee = true。 真正执行时,还会把“冲泡咖啡”记录到 steps 里。 |
目标
目标定义在这里:
|
1 2 3 4 5 |
.goal( name = "have-hot-tea", description = "得到一杯热咖啡", condition = { state -> state.hasCoffee } ) |
意思是: 只要 state.hasCoffee == true,就说明目标完成。GOAP planner 会自动找出能让 hasCoffee 变成 true 的动作序列: boil-water -> add-tea-leaves -> brew-tea。最后 CoffeeState.provideOutput() 把状态转成最终字符串:
|
1 2 3 4 5 6 |
override fun provideOutput(): String = """ 目标:$agentInput GOAP 执行动作:${steps.joinToString(" -> ")} 当前状态:${if (hasCoffee) "已经准备好一杯热咖啡。" else "还没有完成目标。"} """.trimIndent() |
所以最终输出是:
|
1 2 3 |
目标:准备一杯热咖啡 GOAP 执行动作:烧开水 -> 磨咖啡豆 -> 冲泡咖啡 当前状态:已经准备好一杯热咖啡。 |
成本函数
再细说一下 cost :
|
1 2 3 4 5 |
.action( name = "boil-water", cost = { state -> 1.0 }, ... ) |
表示“烧开水”这个动作成本为 1。
如果有两个动作都能达成类似效果:
|
1 2 3 4 5 6 7 8 9 10 11 |
.action( name = "boil-water-with-kettle", cost = { 1.0 }, ... )
.action( name = "boil-water-with-pot", cost = { 3.0 }, ... ) |
GOAP 通常会优先选:boil-water-with-kettle,因为成本更低。在 goal 里也有 cost:
|
1 2 3 4 5 6 7 |
.goal( name = "have-hot-tea", cost = { state -> listOf(!state.hasBoiledWater, !state.hasCoffeeBeans, !state.hasCoffee).count { it }.toDouble() }, condition = { state -> state.hasCoffee } ) |
这里的 cost 更像是“启发式估算”:当前状态离目标还有多远。比如初始状态:
|
1 2 3 |
hasBoiledWater = false hasCoffeeBeans = false hasCoffee = false |
那么 listOf(true, true, true).count { it } == 3, 表示离目标还差 3 件事。如果已经烧好水、磨好咖啡豆:
|
1 2 3 |
hasBoiledWater = true hasCoffeeBeans = true hasCoffee = false |
那么 listOf(false, false, true).count { it } == 1, 表示离目标只差 1 件事:冲泡咖啡。所以:
action.cost = 执行某个动作的成本
goal.cost = 当前状态距离目标的估算成本
GOAP 内部用类似 A* 的搜索:已花费成本 + 预计剩余成本 来选择下一条更优路径。当前的例子里:每个 action 的成本都是 1,没有优先级差异,表示每个动作成本相同,真正决定顺序的是:precondition、belief、gold.condition。如果想影响选择路径,就可以改 cost。例如“用电热水壶烧水”成本低,“用锅烧水”成本高,GOAP 就会优先选择电热水壶。
另外补充说明一点:
description 是说明文字,不影响当前逻辑。
name 是动作/目标的标识符,可以自定义,但应该稳定且唯一。
action 中的 description 可以随便写,甚至可以是 null,它不参与判断,也不参与执行逻辑。但是 name 不能完全随便,name 会被 GOAP planner 用来记录计划里的动作序列。Koog 的 GOAPPlanner 内部生成的 plan 是 List,也就是 action name 列表。执行时会根据 name 找回对应 action。所以 name 可以自己定义,但同一个 GOAP strategy 里最好保持唯一,一旦 plan 里记录了这个 name,执行阶段就靠它找 action,如果有重复 name,可能找到非预期 action,如果改名但旧 plan/快照还在,可能恢复执行失败。
和 SompleLLMPlanner 的区别就是:SimpleLLMPlanner 是让 LLM 生成计划;GOAP 是你用代码定义规则,算法根据规则自动规划。
八、总结
Koog Agent 的核心不是一次模型调用,而是由 prompt executor、strategy、tools 和 features 组成的运行结构。
Agent 类型对比
| 类型 | 官方文档中的定位 | 需要注意的点 |
|---|---|---|
| Basic Agent | 使用预定义 strategy,适合常见简单流程 | 适合先上手 |
| Graph-based Agent | 显式状态机,nodes 表示动作,edges 表示数据流 | 可视化、状态持久化、可组合 |
| Functional Agent | 用函数实现 Agent 逻辑 | 快速原型;不易可视化;没有状态持久化 |
| Planner Agent | 规划并执行多步骤任务 | Beta 能力 |
后续文章会在这个基础上继续展开 Prompt、Tools 和 Strategy Graph。