本文以Python3.9.1读取data.xlsx中包含的西瓜数据集3.0数据为例,数据集如下:
| 编号 |
色泽 |
根蒂 |
敲声 |
纹理 |
脐部 |
触感 |
密度 |
含糖率 |
好瓜 |
| 1 |
青绿 |
蜷缩 |
浊响 |
清晰 |
凹陷 |
硬滑 |
0.697 |
0.46 |
是 |
| 2 |
乌黑 |
蜷缩 |
沉闷 |
清晰 |
凹陷 |
硬滑 |
0.774 |
0.376 |
是 |
| 3 |
乌黑 |
蜷缩 |
浊响 |
清晰 |
凹陷 |
硬滑 |
0.634 |
0.264 |
是 |
| 4 |
青绿 |
蜷缩 |
沉闷 |
清晰 |
凹陷 |
硬滑 |
0.608 |
0.318 |
是 |
| 5 |
浅白 |
蜷缩 |
浊响 |
清晰 |
凹陷 |
硬滑 |
0.556 |
0.215 |
是 |
| 6 |
青绿 |
稍蜷 |
浊响 |
清晰 |
稍凹 |
软粘 |
0.403 |
0.237 |
是 |
| 7 |
乌黑 |
稍蜷 |
浊响 |
稍糊 |
稍凹 |
软粘 |
0.481 |
0.149 |
是 |
| 8 |
乌黑 |
稍蜷 |
浊响 |
清晰 |
稍凹 |
硬滑 |
0.437 |
0.211 |
是 |
| 9 |
乌黑 |
稍蜷 |
沉闷 |
稍糊 |
稍凹 |
硬滑 |
0.666 |
0.091 |
否 |
| 10 |
青绿 |
硬挺 |
清脆 |
清晰 |
平坦 |
软粘 |
0.243 |
0.267 |
否 |
| 11 |
浅白 |
硬挺 |
清脆 |
模糊 |
平坦 |
硬滑 |
0.245 |
0.057 |
否 |
| 12 |
浅白 |
蜷缩 |
浊响 |
模糊 |
平坦 |
软粘 |
0.343 |
0.099 |
否 |
| 13 |
青绿 |
稍蜷 |
浊响 |
稍糊 |
凹陷 |
硬滑 |
0.639 |
0.161 |
否 |
| 14 |
浅白 |
稍蜷 |
沉闷 |
稍糊 |
凹陷 |
硬滑 |
0.657 |
0.198 |
否 |
| 15 |
乌黑 |
稍蜷 |
浊响 |
清晰 |
稍凹 |
软粘 |
0.36 |
0.37 |
否 |
| 16 |
浅白 |
蜷缩 |
浊响 |
模糊 |
平坦 |
硬滑 |
0.593 |
0.042 |
否 |
| 17 |
青绿 |
蜷缩 |
沉闷 |
稍糊 |
稍凹 |
硬滑 |
0.719 |
0.103 |
否 |
代码段:
一、读取工作表内容(.xlsx转化为DataFrame)
导入pandas库,读取工作表数据
|
1
2
|
import pandas as pd
df = pd.read_excel(r'E:\Aownplan\data.xlsx')#默认读取工作簿中第一个工作表,默认第一行为表头
|
备注:r是为了读取文件路径中\字符,防止转义。
此处利用pandas库的 read_excel 函数读取文件,获取到的函数返回值类型为DataFrame,后续所有的操作均是基于DataFrame的数据操作方法进行。
二、获取指定行指定列数据(DataFrame转化为numpy.ndarray)
获取整个工作表数据
|
1
2
|
data=df.values#获取整个工作表数据
print("读取整个工作表的数据:\n{0}".format(data))
|
获取某一行数据
|
1
2
|
data=df.iloc[0].values#0表示第一行,不包含表头
print("读取指定行的数据:\n{0}".format(data))
|
获取多行数据
|
1
2
3
4
5
6
7
8
|
data=df.head().values#head()默认读取前5行数据(不包含表头)
print("获取工作表前5行数据:\n{0}".format(data))
data=df.iloc[[1,2]].values#读取指定多行,在iloc[]里面嵌套列表指定行数
print("读取指定多行的数据:\n{0}".format(data))
data=df.sample(3).values#读取df中随机3行数据(3个样本)
print("获取随机多行数据:\n{0}".format(data))
|
获取指定单元格数据
|
1
2
|
data=df.iloc[1,2]#读取索引为[1, 2]的值,这里不需要嵌套列表
print("读取指定某行某列(单元格)的数据:\n{0}".format(data))
|
获取指定列数据
|
1
|
print("输出值\n",df['含糖率'].values)
|
获取指定多列数据
|
1
2
|
data=df.loc[:,['敲声','纹理']].values#读所有行的敲声以及纹理列的值,这里需要嵌套列表
print("读取指定列的数据:\n{0}".format(data))
|
获取指定多行多列数据
|
1
2
|
data=df.loc[[1,2],['密度','含糖率']].values#读取第一行第二行的密度以及含糖率列的值,这里需要嵌套列表
print("读取指定多行多列的数据:\n{0}".format(data))
|
获取行号和列标题
|
1
2
|
print("输出行号列表",df.index.values)
print("输出列标题",df.columns.values)
|
三、数据处理(numpy.ndarray转化为list/set/dict)
(1) 转化为列表list
以上通过.values方法获取到的data值,均为二维值数组(numpy.ndarray)类型,在使用时如果需要转换为列表类型,可使用.tolist()方法,如:
|
1
|
data=df.values.tolist()
|
此时的输出为:
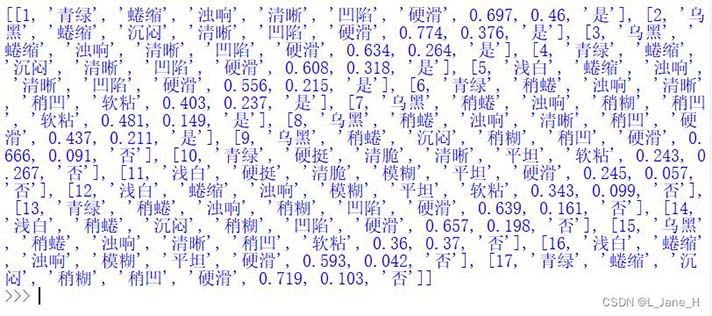
此时的data为list类型,其中每一行数据均为一个列表,多个列表合并为一个二维列表,此时要获取指定行(m)的数据,使用 data[m],获取指定单元格数据,使用data[m][n]。
(2) 转化为集合set
在分析时,若想获取某一列的数据集合,则可以先提取该列数据,然后使用set()函数将其转化为集合即可,如当前为获取敲声的类型,进行如下操作:
|
1
2
|
data=df['敲声'].values
print(set(data))
|
此时的输出:
{'清脆', '浊响', '沉闷'}
获取除编号,密度,含糖率外所有列的集合:
|
1
2
3
4
5
6
|
titles = df.columns.values
for title in titles:
if title != '编号' and title != '密度' and title != '含糖率':
key = df[title].values
values = set(key)
print(title,':',values)
|
输出:
色泽 : {'乌黑', '青绿', '浅白'}
根蒂 : {'蜷缩', '稍蜷', '硬挺'}
敲声 : {'清脆', '浊响', '沉闷'}
纹理 : {'清晰', '稍糊', '模糊'}
脐部 : {'平坦', '稍凹', '凹陷'}
触感 : {'硬滑', '软粘'}
好瓜 : {'是', '否'}
(3) 转化为字典dict
如果需要读取某一行的数据为字典,可进行如下操作:
|
1
2
3
4
|
data=df.iloc[0].values#获取某行数据
title=df.columns.values#获取列标题
a=zip(title,data)#将其压缩为一个元组
print(dict(a))#转化为字典
|
输出:
{'编号': 1, '色泽': '青绿', '根蒂': '蜷缩', '敲声': '浊响', '纹理': '清晰', '脐部': '凹陷', '触感': '硬滑', '密度': 0.697,'含糖率': 0.46, '好瓜': '是'}
获取除编号,密度,含糖率外所有列的字典:
|
1
2
3
4
5
6
7
|
titles = df.columns.values
adict=dict()
for title in titles:
if title != '编号' and title != '密度' and title != '含糖率':
key = df[title].values
adict[title]=set(key)
print(adict)
|
输出:
{'色泽': {'乌黑', '青绿', '浅白'}, '根蒂': {'蜷缩', '稍蜷', '硬挺'}, '敲声': {'清脆', '浊响', '沉闷'}, '纹理': {'清晰', '稍糊', '模糊'}, '脐部': {'平坦', '稍凹', '凹陷'}, '触感': {'硬滑', '软粘'}, '好瓜': {'是', '否'}}
|