写完第一个插件之后,Harness 的学习曲线会突然变陡。真正的高阶用法不在「怎么注册一个 Tool」,而在理解它的能力三层拆分(Service Definition / Provider / Consumer)—— 这条 seam 是子代理、工作流、上下文压缩、技能、沙箱等几乎所有可选能力的统一骨架。掌握它,你才能替换实现而不动调用方、给同一服务开多个隔离实例、写自己的 LLM 适配器、编排可继续的后台子代理。本文按这条主线串起十一个高阶主题,全部给出官方文档中的原始代码与字段。
一、高阶的分界线:从「装插件」转向「改架构」
入门阶段的关注点是:怎么装插件、怎么写 Tool、配置为什么不生效。到了高阶,问题变成三类:
- 我要换掉某个内置实现(换 Bash 执行器、换 LLM 后端、换压缩策略),但不想动调用方代码
- 我要让同一个服务在不同场景下有不同配置(一组插件用 5 秒超时,另一组用 60 秒)
- 我要编排多个 agent 协作,而不是让一个 agent 从头做到尾
这三件事在 Harness 里有统一答案,就是下一节的三层拆分。理解不了它,你会发现文档里 dsh-shell、dsh-bash-local、dsh-tool-bash 这种三个包干一件事的命名毫无道理;理解了它,整个仓库的包结构会瞬间变得可预测。
二、核心心法:能力的三层拆分(Capability Seams)
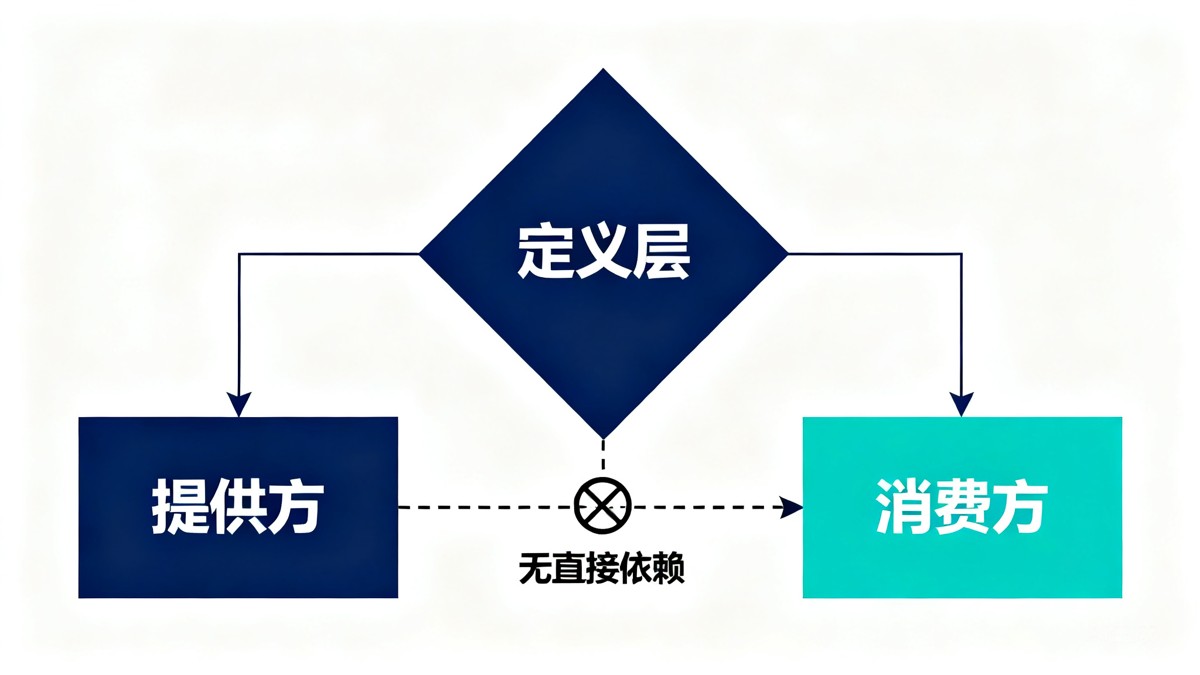
Harness 把一项通用能力拆成三种角色。官方的判据是:「角色需要独立演进或替换时,将它们放入不同包;否则一个包可以承担多个角色」,并强调「完整能力构成其 seam。任何单一角色都不是 seam」。
以 Bash 能力为例:
| 角色 | 包名 | 职责 |
|---|---|---|
| Service Definition | dsh-shell | 定义 Cordis 服务以及 Bash 请求和结果类型 |
| Service Provider | dsh-bash-local | 在本地计算机上执行命令 |
| Consumer | dsh-tool-bash | 将该能力公开为模型可调用的工具 |
关键在于 Provider 与 Consumer 之间没有直接依赖,二者都只依赖 Definition。Consumer 通过 inject: ['shell'] 注入服务后调用,完全不知道背后是本地执行还是远程执行。
这样拆的三个理由,官方写得很直白:
- 提供方可替换:同一 Definition 可对应多个 Provider,通过 cordis.yml 换一行即可切换,「更换提供方时,Service Definition 和工具均保持不变」
- 独立演进:三者变化频率不同 —— 「调用方开始依赖 Service Definition 的约定后,Service Definition 很少改动」,Provider 可独立优化性能与安全,Consumer 可调整能力向模型呈现的方式
- 依赖解耦:Provider 和 Consumer「互不依赖」
完整三步实现
第一步,Service Definition(packages/my-cap/my-cap/src/index.ts):
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
import { Service, type Context } from '@deepseek-ai/cordis' declare module '@deepseek-ai/cordis' { interface Context { myCap: MyCapService } } export abstract class MyCapService extends Service { constructor(ctx: Context) { super(ctx, 'myCap') } /** Execute the capability. */ abstract execute(request: MyCapRequest): Promise<MyCapResult> } export interface MyCapRequest { input: string } export interface MyCapResult { output: string } |
第二步,Service Provider(packages/my-cap/my-cap-local/src/index.ts):
|
1 2 3 4 5 6 7 8 9 10 11 12 |
import type { Context } from '@deepseek-ai/cordis' import { MyCapService, type MyCapRequest, type MyCapResult } from '@deepseek-ai/dsh-my-cap' class MyCapLocal extends MyCapService { async execute(request: MyCapRequest): Promise<MyCapResult> { // Local provider behavior. return { output: request.input.toUpperCase() } } } export const name = 'my-cap-local' export function apply(ctx: Context) { ctx.plugin(MyCapLocal) } |
第三步,Consumer(packages/my-cap/tool-my-cap/src/index.ts):
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
import type { Context } from '@deepseek-ai/cordis' import { defineTool } from '@deepseek-ai/dsh-tools' export const name = 'tool-my-cap' export const inject = ['tools', 'myCap'] export function apply(ctx: Context) { ctx.tools.register(defineTool({ name: 'my_cap', description: 'Execute my capability.', parameters: { input: { type: 'string', required: true }, }, output: { schema: { type: 'string' }, render: (_args, value) => [{ type: 'text', text: value }], }, async execute(args) { const result = await ctx.myCap.execute({ input: args.input }) return result.output }, })) } |
在 cordis.yml 里组合:
|
1 2 |
- name: '@deepseek-ai/dsh-my-cap-local' - name: '@deepseek-ai/dsh-tool-my-cap' |
三条设计纪律
官方明确列出三条,值得抄在墙上:
- 「不要预防性拆分」 —— 仅当角色确需独立演进时才分包,简单工具插件无需拆分
- 「Service Definition 拥有 Request/Result 类型」 —— Provider 与 Consumer 只依赖 Definition 包
- 「显式优于隐式」 —— 默认值应通过显式的 resolve(request): Spec 步骤处理,而非在 run() 里藏 ?? default
第三条最容易违反。把默认值散在实现里,换 Provider 时行为会莫名其妙地变,而调用方根本看不出来。
三、服务与依赖:inject、可选依赖、自动 dispose、隔离
tools、llm、agents 都是服务,以命名方式挂在 ctx 上:
|
1 2 3 |
ctx.tools // ToolRuntime service ctx.llm // LLM service ctx.agents // Agent service |
必需依赖用 inject。框架保证:「在 apply 执行时,inject 声明的服务已经全部就绪。如果服务还没准备好,你的插件会等着,不会执行。」
可选依赖不写进 inject,改用 ctx.get() 在使用点查询:
|
1 2 3 4 5 6 7 |
// Required: the plugin does not load while the service is absent. export const inject = ['tools'] // Optional: omit inject and query with ctx.get() at the use site. export function apply(ctx: Context) { const metrics = ctx.get('metrics') metrics?.record('plugin_loaded', 1) } |
这个区分很重要:写进 inject 意味着服务缺席时你的插件根本不加载,写成可选则是降级运行。选错了,表现出来就是「某个无关插件没装,我的插件也跟着消失了」。
服务消失时的生命周期是自动的两步:依赖它的插件自动 dispose,服务重新出现时插件自动重新加载。设计目的是「防止插件调用已不存在的服务」。所以你不需要在代码里防御性地判空一个必需服务。
服务隔离:同一服务的多个实例
这是高阶配置里最有用的一招。用 group + isolate 可以让不同插件组各持有互不干扰的服务实例:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
- id: group-a name: '@deepseek-ai/cordis-plugin-group' group: true isolate: shell: true config: - name: '@deepseek-ai/dsh-bash-local' config: timeoutMs: 5000 - name: './src/plugin-a.ts'
- id: group-b name: '@deepseek-ai/cordis-plugin-group' group: true isolate: shell: true config: - name: '@deepseek-ai/dsh-bash-local' config: timeoutMs: 60000 - name: './src/plugin-b.ts' |
plugin-a 拿到 5 秒超时的 Bash,plugin-b 拿到 60 秒的,两者完全隔离。需要「快操作用短超时、构建任务用长超时」时,这比在业务代码里传参数干净得多。
四、写一个 LLM 适配器:StreamChunk 的六步序列
适配器是 Service Provider 角色的典型案例:把 Harness 的提供方无关请求转成具体 API 调用,再把响应转回 Harness 分片。
需要实现的只有一个方法:
|
1 2 3 4 5 6 |
export const name = 'my-llm-adapter' export const inject = ['llm'] export function apply(ctx: Context, config: Config) { const adapter = new MyAdapter(config.apiKey) ctx.llm.registerAdapter(config.providers, adapter) } |
其中 MyAdapter extends LlmAdapter,必须实现 stream(options: GenerateOptions): AsyncIterable<StreamChunk>;建议覆写 resolveModel(provider, model, signal?),可选覆写 listModels() 用于向选择器公布模型选项。
StreamChunk 协议是六步固定序列,顺序错了会直接崩:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 |
// 1. Start each content block with block-start. yield { type: 'block-start', index: 0, blockType: 'text' } // 2. Stream text through text-delta. yield { type: 'text-delta', index: 0, text: 'Hello' } yield { type: 'text-delta', index: 0, text: ' world' } // 3. End each content block with block-end and the complete block. yield { type: 'block-end', index: 0, block: { type: 'text', text: 'Hello world' }, } // 4. Tool-call block. yield { type: 'block-start', index: 1, blockType: 'tool-call' } yield { type: 'tool-call-delta', index: 1, id: brandString<ToolCallId>('call-123'), name: 'bash', argumentsDelta: '{"command":"ls"}', } yield { type: 'block-end', index: 1, block: { type: 'tool-call', id: brandString<ToolCallId>('call-123'), name: 'bash', arguments: '{"command":"ls"}', }, } // 5. Token usage. yield { type: 'usage', usage: { inputTokens: 100, outputTokens: 50 } } // 6. Finish reason. yield { type: 'finish', reason: { kind: 'stop' } } |
四条硬规则:每个 block-start 必须有配对的 block-end;index 从 0 开始递增;finish 必须是最后一个分片;usage 必须在 finish 之前。argumentsDelta 是原始 JSON 文本的增量,可以一次给完也可以分多片。
错误处理有纪律要求:传输和协议故障必须抛带稳定 code 的 LlmError,agent loop 会保留该 code 用于诊断 —— 「不应依赖普通 Error 被自动转换」。另外每个提供方 HTTP 请求都须合并 attributionHeaders() 并传递 options.signal:
|
1 2 3 4 5 6 7 8 9 10 11 12 |
const response = await fetch(this.endpoint, { method: 'POST', headers: { 'content-type': 'application/json', ...attributionHeaders(), }, body: JSON.stringify({ model: options.model, messages: options.messages }), ...options.signal ? { signal: options.signal } : {}, }) if (!response.ok) { throw new LlmError(`Provider API error: ${response.status}`, 'PROVIDER_HTTP_ERROR') } |
还有一条容易忽略的约束:如果适配器无法支持 GenerateOptions 里的某个字段,必须抛错,不得静默丢弃。静默丢弃会让上层以为参数生效了。
想读参考实现,仓库里有两个完整的:packages/llm/llm-deepseek/(OpenAI 兼容格式)和 packages/llm/llm-pi-ai/(另一种 API 格式)。
如果只是要接一个 OpenAI 兼容的国内端点,不必写适配器 —— 走 settings.yaml 的自定义提供方就够了。七牛云 AI 大模型推理服务的官方接入文档给出的三项参数是:API 地址 https://api.qnaigc.com/v1,模型 ID 在控制台模型广场查询后填入,API Key 在控制台单独获取。写适配器的场景是端点协议不兼容,或者你要在流式层面做自定义处理。
五、子代理编排:六种 Provider 与可继续会话
子代理 seam 是 Harness 里设计最复杂、也最能拉开使用水平的部分。它「让一个 agent 将工作委派给子 agent」,且与 bash 不同 —— 同一上下文中可共存多个提供方实现,按名称注册在 ctx.subagents。
六个 Provider 兄弟包:
| 包名 | 说明 |
|---|---|
| dsh-subagent-spawn-in-process | 进程内新建,不继承父上下文 |
| dsh-subagent-fork-in-process | 进程内 fork,注入父级已完成轮次前缀 |
| dsh-subagent-acp | 走 ACP 协议 |
| dsh-subagent-codex | 委派给 Codex |
| dsh-subagent-claude-code | 委派给 Claude Code |
| dsh-subagent-dsh-sdk | 走 DSH SDK |
模型侧消费方是 dsh-tool-subagent(按提供方委派)与 dsh-tool-subagent-control(send_message、interrupt_agent、list_agents)。
能力发现是静态的,请求不具备的能力会被 SubagentError('UNSUPPORTED_CAPABILITY') 拒绝:
|
1 2 3 4 5 6 7 |
interface SubagentCapabilities { readonly agentOptions: boolean readonly outputSchema: boolean readonly depthLimit: boolean readonly toolFilter: boolean readonly persona: boolean } |
这解释了一个高频困惑:同样的 agentOptions 参数,进程内后端会「合并到父 Agent 选项之上」,而 ACP、Codex、Claude Code 三家会在启动传输前直接拒绝。不是 bug,是能力矩阵不同。
上下文继承也不一样:fork 后端注入父级「平衡的已完成轮次前缀」作为对话种子;spawn 与 acp 不继承上下文,由 inheritsParentContext 字段区分。每个子 agent 都拿到「新的扁平作用域,而非继承父级注册」。
委派深度由持久 SessionHeader.delegationDepth 与运行时 AgentOptions.subagentDepth 共同表示,进程内子 agent 持久保存「parent 深度 + 1」,且冷恢复「无法降低深度」—— 这是防无限递归的兜底。想设上限要用 maxDepth,但它需要 depthLimit 能力。
工具裁剪用 toolFilter(需 toolFilter 能力),效果是「该工具从子 agent 提示词消失且拒绝执行」—— 注意是双重的,既不告诉模型有这个工具,真调了也拒绝。
可继续子代理与 Activation
这是子代理里最容易用错的部分。可继续后台 subagent 是「一份持久化子 agent 会话,至多关联一个进程内的 Activation」:
|
1 2 3 4 5 |
persisted Session -> optional live Activation -> one retained AgentHandle -> Agent inbox as the only turn FIFO -> zero or more owned child Activations |
sendMessage() 的投递行为取决于目标 Activation 状态:
| 目标 Activation 状态 | sendMessage 行为 |
|---|---|
| running | 在同一 Activation 中 steer 最近的 step |
| waiting | 唤醒并 steer 同一 Activation |
| 无 Activation | 冷恢复新的 Activation,然后 steer |
权限校验是严格的父子双向:「parent 到 child 的投递要求目标的 SessionHeader.parentSession 指向 sender;child 到 parent 的投递要求 sender 的驻留 Activation 指向目标」。sibling(兄弟之间)、跨多边 ancestor、self-target 全部被拒绝 —— 想让两个子代理互相通信是做不到的,必须经由父级中转。
结果与停止原因
|
1 2 3 4 5 6 |
interface SubagentResult { readonly output: ContentBlock[] readonly structured?: unknown readonly diagnostic?: string readonly stopReason: SubagentStopReason } |
stopReason 枚举:completed、aborted、error、max-tokens、refusal。
一个必须知道的行为差异:SubagentRun.result 这个 Promise 不会因子级失败而 reject,而是以非 completed 的 stopReason resolve;只有基础设施故障才 reject。所以用 try/catch 包住它、指望捕获子代理执行失败,是抓不到的 —— 必须检查 stopReason。
diagnostic 字段有硬性脱敏要求:提供方须「排除工具输入、文件内容、环境值、凭证与原始协议载荷」,并「限制在 4096 个 UTF-8 字节以内」。
六、工作流引擎:让模型编写编排脚本
工作流 seam 让 agent 执行「由模型编写、会启动 subagent 的编排脚本」。与子代理相反,它每个上下文只允许一个引擎实现提供 ctx.workflowEngine,没有命名注册表 —— 新引擎替换旧引擎而非共存。
默认 Provider 是 dsh-workflow-worker-thread,基于 node:worker_threads,「每个 run 一个 worker,脚本的 vm 上下文位于其中」。
WorkflowStartRequest 的 script 字段是「plain-JS script body(允许 top-level await;以 return <json-value> 结尾)」。安全上有一条关键设计:引擎「绝不会通过对脚本文本求值来获取」meta 和 args,二者单独传入并做 schema 校验 —— 避免了从模型生成的脚本里提取元数据这种危险做法。
结果模型:
- stopReason 是封闭联合 completed | cancelled | error
- 非完成态「消费方将其映射为 isError 工具结果,而非把部分输出当作成功上报」
- result 同样不会被拒绝,脚本失败兑现为 stopReason: 'error'
组合器的失败纪律值得注意:WorkflowError.fatal 用于钩子误用(错误参数、非法 agent() 选项等),parallel()/pipeline() 组合器对 fatal 错误直接重新抛出,而非将该项映射为 null —— 也就是说参数写错不会被并行组合器悄悄吞掉。
事件序列是 workflow/start → workflow/phase → workflow/log → workflow/agent-start → workflow/agent-end → workflow/end。workflow/end 特意不携带 result value,理由是「观察结果的监听器不得收到调用方 result 的可变别名」。
另外 WorkflowMeta.phases 字段「仅用于进度展示……不暗示任何执行结构」—— 别指望写了 phases 就有阶段化执行语义。
七、上下文压缩与工具结果剪枝
压缩同样是三层 seam:Definition dsh-compaction(ctx.compaction)、Provider 如 dsh-compaction-basic、Consumer dsh-command-compact。
触发类型只有两种:
|
1 |
type CompactionTrigger = 'pressure' | 'context-overflow' |
四个入口的分工:
- 压力压缩在 agent/pre-step waterfall 中运行,先于请求推导
- compactIfNeeded(agent, trigger, signal) 处理自动策略
- compactNow(agent, signal) 作为「轮次之间的 agent maintenance」运行,未达阈值也可对空闲会话缩减
- compactRegion(...) 针对显式指定范围强制压缩
边界规则很关键:「区域边界保持工具调用/结果配对,但不保持整个轮次」。所以一个过大轮次中较早关闭的步骤可以被单独压掉。校验配对完整性用 toolPairingBalancedBefore(session, seq) 和 toolPairingBalancedAfter(session, seq)。
压缩之前还有个可选前置步骤 —— 工具结果剪枝服务 ctx.toolResultPruner:
|
1 2 3 |
measureContent(blocks: readonly ContentBlock[]): number pruneContent(blocks: readonly ContentBlock[]): ContentBlock[] | null pruneSession(session: Session): PruneResult |
它有个细节做得很正:「Text slicing is by Unicode code point, not UTF-16 code unit, so a retained boundary cannot split a surrogate pair」—— 按码点切,不会把代理对切成半个字符。
计价上有明确分工:压缩 seam「不拥有计价 API:单例 ctx.tokenMeter 直接拥有估算与回放」;剪枝产出的 compaction/prune 事件「通过注入的 token meter 为被遮蔽节点定价」。
手动压缩的失败码是封闭枚举,排错时对照它比看日志快:
|
1 2 3 |
type ManualCompactionErrorCode = | 'busy' | 'cancelled' | 'changed' | 'summary' | 'commit' | 'persistence' |
其中 commit 「可能发生在部分变更之后」,persistence 表示「内存中的标记对已闭合,但 flush 失败」—— 这两个是有副作用的失败,不能简单重试了事。
还有一个运维提示:压缩用「锁括住整个操作」,且「最后释放锁意味着操作中途崩溃会表现为可检测的遗留锁」。看到遗留锁就知道上次压缩崩了。
八、技能系统:六级发现优先级与分层注册表
技能名必须是 kebab-case,正则 ^[a-z0-9]+(?:-[a-z0-9]+)*$。本地提供方支持两种组织形式:目录包 <name>/SKILL.md,或扁平文件 <name>.md。「嵌套递归的 **/SKILL.md 发现不受支持」 —— 把技能塞进多层子目录是找不到的。
发现按 rank 顺序扫描六个根目录:
| Rank | Source | Root |
|---|---|---|
| 100 | project-dsh | <projectRoot>/.dsh/skills |
| 200 | project-agents | <projectRoot>/.agents/skills |
| 300 | custom | Config.customSkillDirs |
| 400 | user-dsh | <dshHome>/skills |
| 500 | user-agents | <agentsHome>/skills |
| 600 | bundled | Config.bundledSkillDir |
两条补充规则:「项目根目录为包含 .git 的最近祖先目录;找不到时使用当前 cwd」;「用户 DSH 根目录会跳过其 .system 子目录」。
注册表是分层的,这点最容易搞错:宿主行与 repository 插件落入全局层,Agent preset 常驻组合挂载的插件落入该 preset 的层。「提供方名称在每层内唯一,而非进程级唯一」,读取时「最近层的条目直接赢得重名 skill」,rank 顺序仅在单层内裁决。也就是说 rank 表只在同一层里比较 —— 跨层是层近者胜,rank 说了不算。
frontmatter 有两个开关键,都是 kebab-case 且需名称完全匹配:disable-model-invocation 和 user-invocable,「省略的字段默认为 true」。
模型调用 skill({ name }) 时是双重策略检查:加载前通过 isModelInvocable 拒绝无权访问的,读完完整定义后「在返回内容前再次检查策略」。还有个性能相关的设计:「仅按需解析显式引用的脚本、参考资料和资产;加载结果不枚举 skill 目录」—— 技能包里放大量文件不会拖慢加载。
九、权限预设:两个 knob 的组合封装
权限预设服务把两个独立开关捆成命名预设:沙箱模式(sandbox/mode)与审批策略(approval/policy)。它本身「不属于 agent loop 主干,也不拥有任何强制执行」—— 只是切换入口。
内置两个预设:
| 预设名 | 沙箱模式 | 审批策略 |
|---|---|---|
| workspace-write | workspace-write | ask |
| danger-full-access | danger-full-access | never |
自定义写法:
|
1 2 3 4 5 6 7 8 9 10 |
interface Config { presets?: Record<string, PresetSpec> defaultPreset?: string } interface PresetSpec { sandbox: SandboxMode approval: ApprovalPolicy name?: string description?: string } |
custom 是保留字,被派生的「非预设」状态占用,配置表里出现这个名字会在插件加载时抛异常。
current(session) 的解析优先级是三级:仍然匹配的上次选择 → 声明顺序中第一个匹配的表项 → 否则返回 CUSTOM_PRESET。官方强调「custom 只是派生值……它绝不是切换目标,也绝不出现在事件 payload 中」。
一个依赖前提要注意:该服务需要「施加隔离的 ctx.shell 执行器」和 ctx.approval;如果 bash 执行器不具备隔离能力(缺少 sandboxMode 能力事实),组合会在加载时抛异常。换了自定义 Bash Provider 之后权限预设突然报错,原因通常在这里。
十、三条开箱即用的自动化路径
GitHub PR 评审自动化
这个 overlay 让 dsh web 增加一个签名的 GitHub webhook 端点:当已配置仓库的 PR 从 draft 变为 ready for review 时,「在该仓库的 Web Workspace 下创建带标题的根 Session,并启动只读评审提示词」。
启动:
|
1 2 3 |
export DSH_GITHUB_WEBHOOK_SECRET="$(openssl rand -hex 32)" export DSH_GITHUB_REVIEW_WORKSPACE=/path/to/deepseek-harness pnpm dsh web --patch apps/cli/config/examples/github-review/cordis.yml |
端口设计值得学:主 Web UI 与 /api 在 3080,「overlay 会在隔离 realm 中挂载第二个 WebServer;其中只注册 POST /github,其他路径均返回 404」,默认监听 127.0.0.1:3081。这是很干净的攻击面收敛。
Session 使用 standard agent preset 与 read-only permission preset,并「禁止修改文件、分支、PR 或 GitHub 状态」,传入的 JSON 被「标为不受信任的元数据」。
三个必须知道的边界:
- 202 不代表创建成功:它「表示签名与 JSON 已被接受,规则调用已在内存中调度」,不代表规则匹配或 Session 已创建
- 没有幂等:「webhook runtime 不存储交付或执行状态。重复交付会运行规则,并可能创建另一个 Session」
- 密钥不等于出站权限:「webhook 密钥只验证入站 GitHub 数据。它不会向规则代码或所创建 Agent 授予出站 GitHub 访问权」
会话内提醒
|
1 |
dsh web --patch apps/cli/config/examples/schedule/cordis.yml |
模型通过 schedule_create、schedule_list、schedule_delete 三个函数管理。时间参数三选一:after_seconds(正整数)、at(绝对时间)、every_seconds(至少 300 秒)。
不支持 cron 表达式和日历表达式,这点和大多数人的预期不同。at 的格式要求严格:「必须是带 Z 或数值偏移量且严格符合 RFC 3339 的日期时间,或是带显式 UTC 或 IANA Area/Location 时区的 { date, time, time_zone }」。夏令时缺口会被拒绝,重叠时段取第一个时刻。
行为特点:提醒「由原 Session 日志拥有」,关进程只停内存 timer 不删记录,重开同一 Session 会「恢复等待并交付逾期提醒」;fork 不会继承父 Session 的提醒。交付时机是「live 根 Agent 等待完全 idle 后,在该对话中排入一个普通 follow-up 轮次」,不打断当前工作。
最重要的一条预期管理:Schedule 不提供浏览器、操作系统、邮件、短信等任何外部通知,持久 dispatch 只记录 follow-up 已入队,「不确认模型成功或用户已收到提醒」。它是会话内提醒,不是闹钟。
记忆 MCP
三份默认关闭的参考配置,通过 @deepseek-ai/dsh-mcp-client 连接:
|
1 |
dsh web --patch "$PWD/apps/cli/config/examples/mcp-memory/memorix.cordis.yml" |
DSH 的职责边界划得很清:它负责「解析选中的 Cordis overlay,启动已配置的 stdio 命令或连接已配置的 Streamable HTTP URL,发现 MCP 工具」,并按 mcp__<serverName>__<tool> 命名公开;不负责下载服务器、初始化数据库、选择模型或 embedding 提供方。
一个安全设计值得所有做 MCP 集成的人抄:stdio 桥接器在启动子进程前会移除环境中代表凭据的变量及所有 DSH_* 变量 —— 防止把宿主凭据泄漏给第三方 MCP 进程。
验证记忆是否真的跨会话生效,官方给了三步法:会话 A 写入一个含唯一后缀的值 → 新建会话 B(同一 Host,不复制历史)要求「检查记忆」召回 → 在 B 中要求基于该偏好给建议,确认召回值被实际使用。注意「必须新建 DSH 会话,但不需要重启 Host」。
十一、Python SDK:把 Harness 当库用
|
1 |
python -m pip install deepseek-harness-sdk |
安装内容「包含匹配的原生运行时 wheel 与 dsh 命令」,普通运行不需要系统 Node.js(只有执行插件管理命令时才需要 pnpm)。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
from pathlib import Path from deepseek_harness import DeepSeekHarness workspace = Path("/absolute/path/to/disposable-workspace").resolve() dsh_home = Path("/absolute/path/to/example-dsh-home").resolve() with DeepSeekHarness( provider="deepseek-official", model="deepseek-v4-flash", max_tokens=49_152, cwd=str(workspace), dsh_home=str(dsh_home), profile="sdk-minimal", ) as harness: result = harness.run( "Inspect the repository and fix the failing tests.", session_id="example-001", ) print(result.final_response) |
极简 profile 的默认值:系统提示词取 DSH_SYSTEM_PROMPT,未设置则为 You are a helpful software engineer assistant.;模型解析顺序是 --model → DSH_MODEL → deepseek-v4-flash;工具只有 bash(Windows 为 pwsh)和 str_replace_editor;Shell 超时 300 秒;Editor 输出上限 16,000 字符;会话以未压缩 JSONL 存在 <dsh_home>/sessions。
一条必须注意的安全提示:这个极简 profile「固定使用 danger-full-access」,官方建议配合一次性 checkout 或容器使用。别直接指向你的主仓库。
十二、运行时动态挂载插件(谨慎使用)
@deepseek-ai/dsh-tool-cordis 允许运行中的智能体「检查当前 Cordis 进程,并在内存中挂载或卸载模型编写的插件」。
|
1 |
pnpm dsh web --patch apps/cli/config/examples/cordis/cordis.yml |
两条限制必须先看清:临时插件「会在卸载或进程退出时消失」,且**「影响同一进程中的其他会话」** —— 作用域是进程级而非会话级。也就是说一个会话里让模型挂个插件,会影响同进程的所有其他会话。这在多人共用一个实例的场景下是明确的风险,上生产前务必想清楚。
十三、高阶避坑清单
| 症状 | 真实原因 |
|---|---|
| 换了 Bash Provider,权限预设加载报错 | 新 Provider 缺少 sandboxMode 能力事实 |
| 子代理传 agentOptions 被拒 | ACP/Codex/Claude Code 后端在启动传输前拒绝该字段 |
| try/catch 抓不到子代理失败 | result 不 reject,须检查 stopReason |
| 两个子代理无法互发消息 | sibling 投递被明确拒绝,必须经父级中转 |
| 技能放进子目录后找不到 | 不支持递归 **/SKILL.md 发现 |
| rank 高的技能没赢 | 跨层是层近者胜,rank 只在单层内裁决 |
| 设了 cron 表达式的提醒不生效 | Schedule 不支持 cron,只有三种时间参数 |
| webhook 返回 202 但没建 Session | 202 只表示签名与 JSON 被接受 |
| 无关插件没装,我的插件也消失 | 写进了 inject,应改用 ctx.get() 可选依赖 |
| 换 Provider 后行为莫名改变 | 默认值藏在 run() 里,应显式 resolve() |
十四、收尾
Harness 的高阶用法可以浓缩成一条主线:先认三层 seam,再看每个可选能力是怎么套用它的。子代理是多 Provider 共存的 seam,工作流是单引擎替换的 seam,压缩和技能各有自己的 Definition / Provider / Consumer 分工 —— 一旦这个模式认出来,剩下的只是查各自的字段表。
反过来说,如果你还在按「装插件、改配置」的思路用它,遇到上面清单里那十种症状时基本无从下手,因为它们全都是 seam 语义的直接后果,不是配置写错。
本文所有代码、字段名与行为约束均引自官方文档;Harness 迭代很快,落地前建议对照生成参考(reference/config-catalog)核对当前版本的字段与默认值。