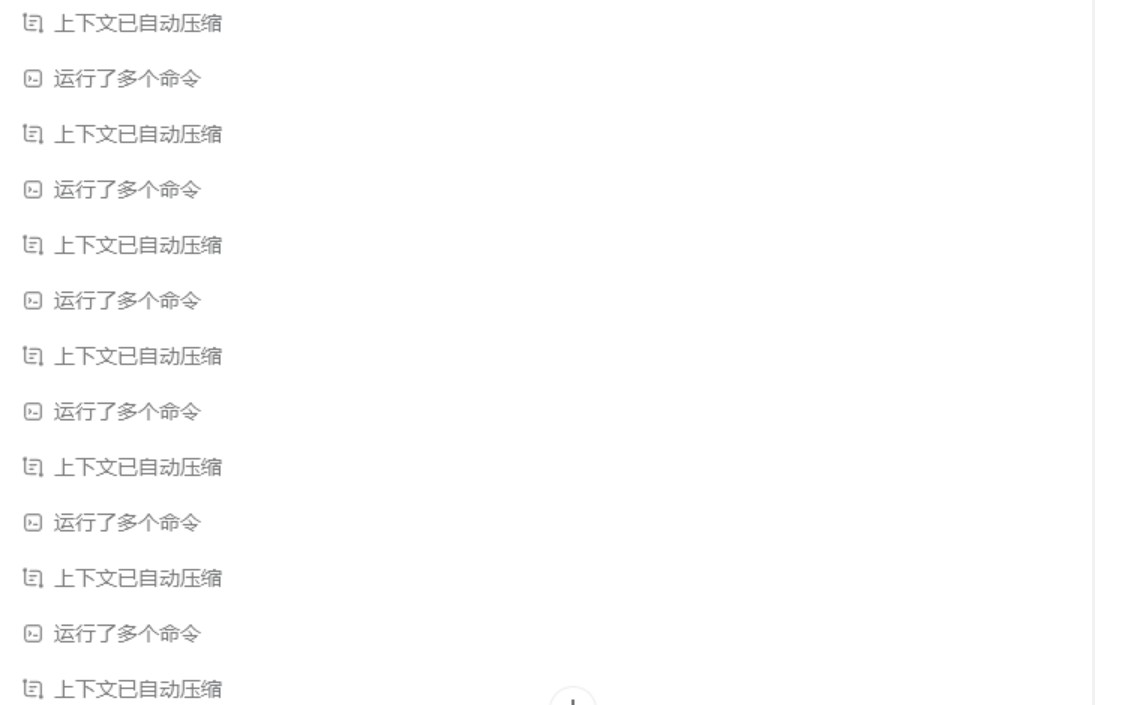
最近看到 论坛上有网友反馈,Codex 跑任务时一直重复压缩上下文,压缩一次又继续压缩,甚至一晚上都停不下来。更奇怪的是,日志里一直提示准备修改,却迟迟没有真正开始干活。本文整理这个问题的排查思路,以及网友后来发现的几个关键原因,遇到 Codex 疯狂压缩的可以参考。
一、Codex为什么会一直压缩?
这个问题最近在使用 Codex 跑长任务的时候比较容易遇到。
论坛上有网友发帖:
也没有大佬救救我 Codex一直压缩循环 经常这样 重复一晚上了
最开始的表现非常典型。
任务启动以后,看起来 Codex 一直在工作,但是过了一晚上回来,发现任务还停留在最开始的阶段。
仔细观察日志会发现:
Codex不断读取日志 → 分析 → 说准备开始修改 → 再读取日志 → 再压缩上下文 → 继续分析。
真正的代码修改反而没有进行多少。
更加奇怪的是,网友发现并不是上下文真的已经大到无法处理,因为有几次甚至不到 20K 就触发了压缩。
所以这个问题不能简单归结为:
“上下文太长了,所以正常压缩。”
二、最开始大家怀疑是上下文太多
帖子里第一批回复基本都认为,问题可能出在上下文空间。
有网友直接表示:
明显上下文太多了,压缩完还是太多,你要么加窗口要么开新会话
这个判断其实并不是完全没有道理。
Codex 做长任务时,会不断累积:
- 用户指令
- 模型思考过程
- 工具调用
- 文件内容
- 日志
- MCP 返回内容
- Skill 内容
- Agent 之间的信息
- 历史会话
这些内容最终都会进入上下文。
当上下文接近模型允许的范围以后,就需要进行压缩。
正常情况下流程应该是:
上下文变长 → 触发压缩 → 压缩历史信息 → 继续任务。
但出现问题以后,可能变成:
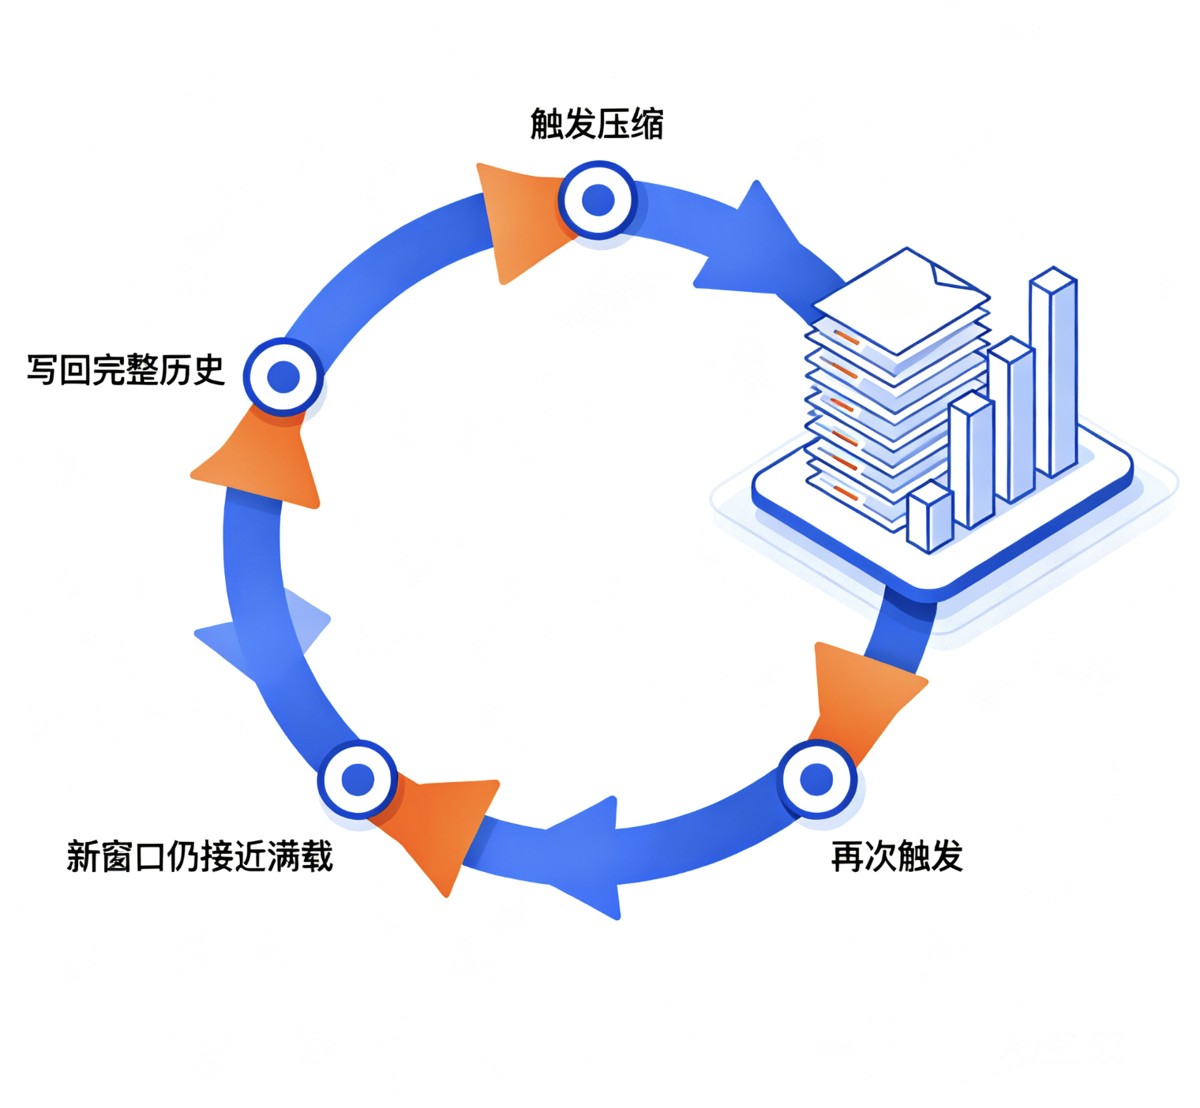
压缩 → 上下文依旧过多 → 再压缩 → 还是不满足 → 再压缩。
最终就形成了所谓的“压缩循环”。
三、但这个案例比较奇怪:不到20K就压缩
后来楼主补充了更加关键的信息。
他发现多次触发压缩时,实际上并没有达到 20K。
也就是说:
都没有20k就压缩了
这就比较值得注意了。
如果上下文只有十几 K 就开始不断压缩,那么单纯解释成“上下文太大”显然说不通。
这时候排查方向就应该从:
“到底用了多少上下文?”
转向:
“Codex到底根据什么条件判断需要压缩?”
四、先检查 AGENTS.md
后来楼主总结了第一个排查方向:
1.agent.md 检查一下是不是太大了
这个问题很多人容易忽略。
AGENTS.md 本身就是 Codex 执行任务时非常重要的上下文来源。
如果里面塞了大量:
- 项目规则
- 开发规范
- 技术说明
- 操作流程
- 历史约定
- 大段代码
- 强制要求
- 自动化规则
那么每次进入任务都会携带大量额外上下文。
尤其是项目根目录和子目录存在多个 AGENTS.md 时,需要特别检查实际生效的规则范围。
建议直接搜索项目:
AGENTS.md
然后检查:
- 文件是不是过大
- 有没有重复规则
- 有没有大段无关说明
- 有没有重复的系统提示
- 有没有要求模型进行大量分析的内容
如果只是一些简单项目规范,没有必要写成几十 KB 的文档。
五、检查上下文窗口是不是异常
第二个排查方向是:
2.打开上下文空间显示 看看是不是默认100多k了
这里其实非常重要。
不要只看 Codex 当前显示的上下文占用,还要关注:
模型实际允许的上下文窗口是多少。
因为不同模型、不同客户端版本、不同配置方式,最终使用的上下文空间可能并不完全一样。
特别是一些第三方模型配置或者自定义模型目录,很容易出现:
客户端认为模型拥有一个上下文窗口,实际模型并没有这么大的上下文能力。
这种情况下就可能出现各种奇怪行为。
例如:
模型上下文窗口配置很大
↓
实际模型上下文能力较小
↓
Codex不断尝试压缩
↓
压缩以后依旧满足不了配置条件
↓
再次压缩
↓
循环
所以遇到异常压缩时,建议首先确认:
- 当前模型
- 上下文窗口
- 自动压缩阈值
- 模型配置文件
- 客户端版本
这些参数是不是互相匹配。
六、还有一个容易被忽略的问题:提示词
楼主后来还提到第三点:
3.agent.md 看看有没有什么引导雷霆大思考的提示词
这里非常值得注意。
有些人为了让 Coding Agent 更认真,会在 AGENTS.md 里面加入非常强的思考要求。
比如:
在执行任何操作之前进行充分分析
必须反复验证
必须完整分析项目所有相关文件
不能遗漏任何可能的问题
先进行全面调查再开始修改
这些规则看起来没有问题。
但是如果写得过度,就可能产生一个副作用:
模型越来越喜欢“分析”,而不是“执行”。
最终就容易出现:
读取文件
↓
分析
↓
读取日志
↓
分析
↓
重新总结
↓
再次分析
↓
准备修改
↓
又开始分析
这也是为什么有时候你会看到 Codex 明明一直有输出,但代码就是没怎么变化。
七、真正值得注意:中转模型可能才是问题来源
到了 9 月 15 日,这个帖子又出现了一个非常关键的后续回复。
有网友表示:
我问gpt说是model_catalog_json的问题,我用中转站就会出现疯狂压缩问题,用订阅就没有
这里出现了一个非常重要的关键词:
model_catalog_json
如果你使用的是自定义模型配置,或者通过第三方接口接入模型,那么 Codex 对模型能力的判断,很可能依赖模型目录中的配置。
简单理解就是:
Codex
↓
读取模型配置
↓
判断模型能力
↓
判断上下文窗口
↓
判断压缩条件
↓
执行任务
如果模型目录中的参数和实际模型能力不一致,就可能产生非常奇怪的行为。
特别是:
客户端认为模型拥有很大的上下文,但实际接口并没有对应能力。
这种情况下,“压缩循环”就值得重点怀疑。
八、为什么订阅正常,中转却疯狂压缩?
这个现象尤其有参考价值。
网友反馈:
用中转站就会出现疯狂压缩问题,用订阅就没有
这说明问题未必出在 Codex 本身。
更准确地说,应该把问题拆成三层:
Codex客户端
↓
模型配置
↓
模型接口
如果原生订阅正常,而更换接口后出现疯狂压缩,那么就要重点检查:
模型名称是否一致
上下文窗口是否一致
模型能力声明是否一致
模型目录配置是否正确
接口返回格式是否符合预期
尤其是自定义模型配置中的上下文参数。
所以不要看到 Codex 压缩循环,就直接认定:
“Codex 出 bug 了。”
也有可能是模型配置与实际接口能力不一致。
九、还有一种解决思路:把压缩阈值调小
帖子最后又出现了一个比较实用的经验:
你把压缩调小 258这样最好,不然长任务和字数多的会炸,我个人体验是这样。
这里的 258 建议大家不要机械照抄。
因为不同版本、不同配置界面的参数含义可能不同。
更值得参考的是这个思路:
不要把压缩阈值设置得过激进,也不要让上下文一直膨胀到极限。
对于经常运行长任务的人,可以尝试调整压缩相关参数,让 Codex 在更合适的时机进行上下文整理。
但需要注意:
压缩太早也不一定是好事。
因为压缩会丢失一部分历史上下文,如果你的任务本来就很依赖前面的详细过程,压缩太频繁反而可能导致模型不断重新理解项目。
所以这类参数最好根据自己的任务类型进行测试。
十、Codex疯狂压缩,可以按照这个顺序排查
我比较建议按照下面这个顺序排。
1、先看是不是AGENTS.md太大
搜索:
AGENTS.md
重点检查有没有:
超长文档
重复规则
大量代码
无关项目说明
重复提示词
2、检查上下文窗口
重点确认:
当前模型
上下文窗口
自动压缩配置
实际模型能力
不要只看客户端显示的数字。
3、检查有没有“过度思考”提示
尤其检查:
AGENTS.md
项目规则
Skill
MCP说明
系统提示
有没有大量要求:
全面分析
反复验证
深入思考
读取全部日志
检查全部文件
这些提示如果堆叠过多,很容易让 Agent 在真正修改代码之前消耗大量上下文。
4、检查model_catalog_json
如果你的 Codex 使用了自定义模型配置,这个地方非常值得看。
重点关注:模型名称
上下文窗口
模型能力
压缩相关配置
接口对应关系
尤其是:
客户端认为的模型能力,和实际接口返回的模型能力,是不是一致。
5、对比不同模型接口
如果你发现:
模型 A:正常
模型 B:疯狂压缩
或者:
原生订阅:正常
第三方接口:疯狂压缩
那么问题范围就已经缩小很多了。
这时候优先检查配置和接口兼容性,而不是继续折腾项目代码。
十一、我认为这个问题最关键的地方
这个帖子最有价值的一点,其实不是“把压缩调成多少”。
而是它暴露了一个现象:
Codex出现异常压缩时,不一定意味着上下文真的太大。
尤其是出现下面这些情况:
- 不到20K就开始压缩
- 压缩以后立即再次压缩
- 反复读取日志
- 一直说准备修改
- 长时间没有实际代码修改
- 只有某个模型接口出现问题
这时候就应该怀疑:
模型配置、上下文参数、Agent规则以及接口兼容性。
不要只盯着“上下文太长”这一条。
十二、最后总结
如果你的 Codex 也经常出现:
一晚上都在压缩
压缩完又继续压缩
日志一直读
一直说马上开始修改
结果代码没改多少
可以先按照下面的思路排查:
AGENTS.md 是否过大
↓
上下文窗口是否合理
↓
有没有过度思考提示
↓
Skill / MCP 是否产生大量上下文
↓
model_catalog_json 是否配置异常
↓
不同模型接口是否表现一致
↓
最后再调整压缩参数
目前从这个帖子里的反馈来看,“模型配置与实际接口能力不一致”是一个值得重点关注的方向。
尤其是使用自定义模型配置时,不要只看模型名字对不对,最好把上下文窗口、能力声明以及实际接口行为一起检查。
对于长时间运行的 Codex 任务来说,稳定的上下文管理比单纯追求更大的上下文窗口更重要。