实时语音合成的延迟工程:首包时间、流式切分与播放侧缓冲

离线合成拼的是吞吐,实时合成拼的是延迟。同一个接口,做有声书时你关心一小时音频要跑多久,做对话助手时你只关心一个问题:用户话音落下到音箱出声,隔了多少毫秒。这条链路的延
|
离线合成拼的是吞吐,实时合成拼的是延迟。同一个接口,做有声书时你关心一小时音频要跑多久,做对话助手时你只关心一个问题:用户话音落下到音箱出声,隔了多少毫秒。这条链路的延迟预算通常只有 800ms~1.2s(超过就明显「卡」),拆开来是三块,每块都有各自的压缩手段。 延迟构成:三块账用户语音结束 ├─ ① 首包时间(TTFA):合成服务从收到文本到吐出第一段音频 ├─ ② 传输+解码:音频块到达客户端并解码进播放队列 └─ ③ 播放缓冲:播放器攒够多少音频才开始出声 ① 首包时间是大头,通常占整链路 60% 以上。它的决定因素不是模型快慢,而是你一次送进去多少文本:整段 500 字送进去,模型要处理完才开始出声;按句切分送第一句,首包立刻从秒级降到几百毫秒。 压缩手段一:句子级流式合成上游 LLM 还在逐 token 生成回复时,TTS 侧就可以开工——这是实时场景最大的结构性优化:按句子边界流式送合成。
async def stream_tts(llm_stream):
    buf = ""
    async for token in llm_stream:
        buf += token
        if sentence_end(buf):          # 。!?;\n 触发
            first, buf = split_sentence(buf)
            yield synth_async(first)   # 上一句在合成,这一句在攒
    if buf.strip():
        yield synth_async(buf)
效果:LLM 生成第一句的时间 + 第一句合成的首包时间,就是用户听到声音的延迟——后面所有句子都在播放的影子里并行完成。整段延迟从「全文生成+全文合成」变成「首句生成+首句合成」,量级差异。 两个细节:句子攒太短会碎(「好的。」单独合成,韵律很怪——设最小长度 8~10 字,不够就等下一个边界);合成并发度控制在 2~3(上一句播放时合成下一句即可,开太高撞限速反而拖慢)。 压缩手段二:预合成高频语料产品里有一批文本是固定的:欢迎语、确认音、错误提示、常用引导句。这些全部预合成存本地,触发即播,零延迟:
PRESET = {
    "greeting":   "assets/audio/greeting.mp3",
    "thinking":   "assets/audio/thinking.mp3",   # 「我想想」垫场音
    "not_found":  "assets/audio/not_found.mp3",
}
thinking 垫场音值得单独说:当 LLM 首 token 延迟大时,先播一句预合成的「我想想」,把感知延迟藏在真实延迟前面——用户听到即时回应,容忍度立刻不同。这是延迟工程里性价比最高的一招。 压缩手段三:播放侧双缓冲客户端播放器别用「下载完再播」,用双缓冲流式播放:缓冲 A 在播时,缓冲 B 在收下一段;A 播完无缝切 B。参数取值经验:
参数速查
小结实时 TTS 的延迟工程没有单点银弹,是三块账各自压缩:流式切分砍首包、预合成砍固定语料、双缓冲砍播放侧。做完这三层,端到端压进 1 秒内是常规水平——用户感知到的不再是「AI 在思考」,而是「对话在流动」。 |
您可能感兴趣的文章 :

-
为什么 PPO 难以做出顶级棋类引擎
第一章 引言如何用 PPO 训练一个中国象棋 AI 1.1 一篇论文引出的问题 2024 年 10 月,腾讯光子工作室(LIGHTSPEED STUDIOS)发表了Mastering Chinese C -
实时语音合成的延迟工程:首包时间、流式切分
离线合成拼的是吞吐,实时合成拼的是延迟。同一个接口,做有声书时你关心一小时音频要跑多久,做对话助手时你只关心一个问题:用户 -
DeepSeek Harness全家桶API配置介绍
发布日期:2026-11-16 | 数据基准:DeepSeek 官方 API 文档、2026-11-13 全家桶 API 公告 | 适用版本:DeepSeek-V4.1-Flash(deepseek-flash)、DSH v0.8.3 2026年 -
Claude Code 迁移指南
???? 痛点直击:为什么需要迁移? 还在为Claude Code的高昂API成本而烦恼?或者因为服务限制而无法使用官方服务?Claude Code Router(CCR)为你提 -
Claude Code入门详细教程:手把手带你Vibe Coding
1. Claude Code 简介Claude Code 是 Anthropic 推出的面向开发者的 AI 编程协作工具。Claude Code 的核心目标是理解你的整个项目,并参与到真实的编码 -
claude-code完整使用教程
1.在idea的终端中,首先检查电脑是否安装node; 2.在终端执行 1 npm install -g @anthropic-ai/claude-code 3.验证是否安装成功 1 claude -version 4.创建全局配 -
DeepSeek Harness完整排错指南:常见故障一次讲清
DeepSeek Harness 是 DeepSeek 开发的开源智能体框架,采用一切皆插件架构。截至 2026 年 11 月 10 日,npm 的 latest 与 next 均指向预览版 0.2.2-rc.1,要 -
Codex CLI命令速查表(2026最新)
Codex CLI 速查表里最让人卡住的不是codex edit,而是codex login和codex config list:登录时不知道模型通道该填哪里,配完又不知道到底有没有生效 -
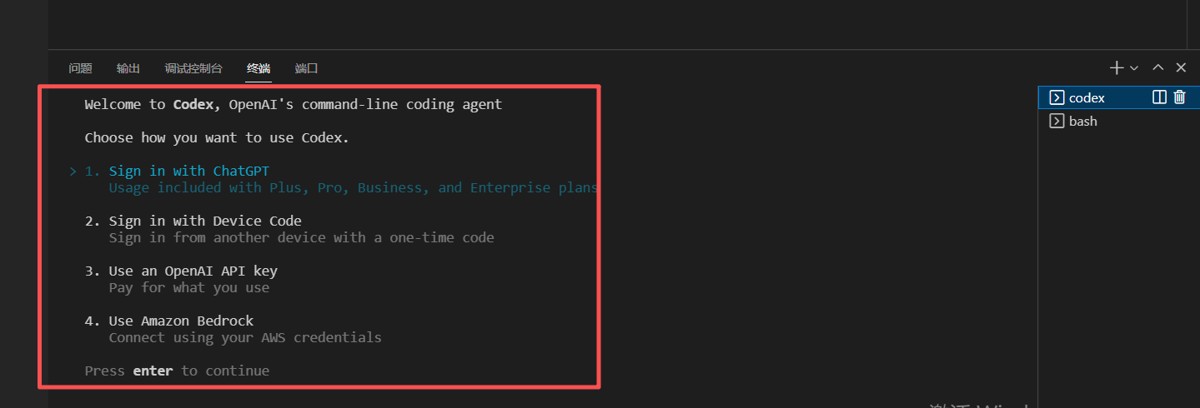
Codex CLI服务器部署,抛弃npm安装!二进制包部署教
阅读提示:本文以 Linux x86_64 服务器为例,其他系统按相应步骤同样适用,解决 npm 全局安装 codex 频繁失败、网络报错问题;文末附带中转
-
Hermes Desktop极简安装教程
2026-07-02
-
Codex CLI配置自定义AI API的完整指南:从
2026-09-06
-
Codex下载与登录全流程分析(Windows/ma
2026-06-24
-
从零到高效开发介绍Codex本地安装与使
2026-06-01
-
WorkBuddy接入Ollama的完整指南
2026-09-18