数据库死锁的成因与代码规避方案介绍

一、什么是数据库死锁 死锁是指两个或多个事务在执行过程中,因争夺锁资源而相互等待,导致所有事务都无法继续推进的状态。数据库通常通过等待图检测死锁,一旦发现环路,就会主动回
一、什么是数据库死锁死锁是指两个或多个事务在执行过程中,因争夺锁资源而相互等待,导致所有事务都无法继续推进的状态。数据库通常通过等待图检测死锁,一旦发现环路,就会主动回滚其中一个事务(牺牲者),让其余事务继续执行。因此死锁并不是“数据库坏了”,而是并发访问下的一种必然可能,关键在于我们能否在代码层面降低发生概率。 死锁的四个必要条件可以简单概括为:互斥、持有并等待、不可剥夺、循环等待。数据库无法消除互斥,但应用代码可以通过统一加锁顺序来打破“循环等待”,这是最有效的规避手段。 二、死锁的典型成因
三、复现一个死锁场景下面用两张账户表模拟转账,两个事务以相反顺序更新账户,这是最经典的死锁模型。
执行后数据库会返回类似 Deadlock found when trying to get lock; try restarting transaction 的错误,说明检测到环路并回滚了其中一个事务。 四、代码层面的规避方案4.1 统一加锁顺序转账时始终按账户 ID 升序加锁,让所有事务的加锁路径一致,从根本上消除循环等待。
4.2 缩短事务并控制锁粒度把远程调用、消息发送等非数据库操作移出事务边界,事务内只保留必要的 SQL,同时确保更新条件命中索引。
4.3 失败重试与降级死锁被数据库回滚后,业务侧应识别该异常并进行有限次重试,而不是直接抛给用户。
五、排查与监控建议线上出现死锁时,优先查看数据库的死锁日志(如 MySQL 的 SHOW ENGINE INNODB STATUS),定位具体 SQL 与加锁顺序。再结合慢查询日志确认是否存在长事务或缺失索引。建议在应用层对死锁异常做埋点统计,当某条链路死锁频率上升时及时告警。 总结来说,死锁无法彻底消除,但通过统一加锁顺序、缩短事务、补齐索引和合理重试,可以把发生概率压到很低,并让系统在偶发死锁时具备自愈能力。 |
您可能感兴趣的文章 :

-
数据库死锁的成因与代码规避方案介绍
一、什么是数据库死锁 死锁是指两个或多个事务在执行过程中,因争夺锁资源而相互等待,导致所有事务都无法继续推进的状态。数据库通 -
Redis过期键删除与内存淘汰策略
使用 Redis 做缓存时,我们通常不会希望一条缓存永久存在。 例如用户信息可以缓存 30 分钟: 1 2 SET user:1001 ... EXPIRE user:1001 1800 30 分钟以后 -
MySQL启动失败报错((code=exited, status=1/FAILURE) )的排
MySQL启动失败 (code=exited, status=1/FAILURE) 这类报错,我在日常运维里碰到过太多次了。搜索资料或者查文档时,看到满屏的 Job for mysqld.service -
MYSQL ID耗尽应急恢复的解决方案
一个经典的应急恢复手段,其核心逻辑是通过重置自增指针来回收利用已被删除数据所占用的ID空洞。 下面从技术原理、操作步骤、风险控 -
MySQL 8.4进阶之多表JOIN、索引与查询优化
MySQL 8.4 进阶:多表 JOIN + 索引与查询优化 这两件事其实是一条线:JOIN 写不对,结果错;JOIN 没索引,性能崩。下面用一套完整的示例库串起 -
在MySQL云数据库RDS中自定义创建高权限账号的介绍
RDS MySQL高权限账号只能通过控制台或API创建,一个实例仅限一个,创建后不可更改类型;不支持SQL语句(如CREATE USER)创建,因其权限由阿里 -
MySQL三大日志 Undo Log、Redo Log、Binlog介绍
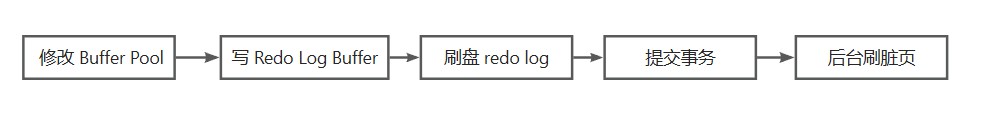
MySQL 的三大日志可以这样理解:Undo Log 管回滚、Redo Log 管崩溃恢复、Binlog 管主从复制和数据归档,它们分别属于 InnoDB 引擎层(前两者)和 -
Mysql 数据库自定义函数实例介绍
MySQL自定义函数(Stored Function)就是你自己封装的一段可复用逻辑,定义后能像NOW()、CONCAT()这些内置函数一样,直接在 SQL 里调用,比如SE -
MySQL的索引语法介绍
一、索引的创建语法(最核心) MySQL 创建索引主要有两套写法: ? 建表时创建(CREATE TABLE) ? 表存在后添加(ALTER TABLE / CREATE INDEX) 二、建 -
MySQL在哪些场景下不会写binlog示例介绍
在 MySQL 中,慢日志不仅可以记录在文件中,还可以记录在表中。具体是记录在文件还是表中是由log_output参数决定的。 该参数默认为FILE,即
-
zabbix监控mysql的实例方法
2021-06-02
-
MySQL时间类型的选择
2021-06-05
-
MySQL数据库基本SQL语句教程之高级操作
2022-06-27
-
MySQL文件权限存在的安全问题和解决方
2024-07-31
-
利用Mysql定时+存储过程创建临时表统
2024-02-19