Ollama本地大模型部署指南:Ollama安装和LangChain调用教程

本文以 Ollama 为例,介绍如何在本地部署并运行大模型。内容包括 Ollama 的跨平台安装(Linux/Windows)、模型下载与交互、常用命令速查,以及通过 LangChain 的ChatOllama和init_chat_model()两种方式调用
|
本文以 Ollama 为例,介绍如何在本地部署并运行大模型。内容包括 Ollama 的跨平台安装(Linux/Windows)、模型下载与交互、常用命令速查,以及通过 LangChain 的 ChatOllama 和 init_chat_model() 两种方式调用本地模型,帮助读者快速搭建一套可用的本地大模型开发环境。 1. Ollama的介绍
2. Ollama的下载-安装Ollama项目支持跨平台部署,目前已兼容Mac、Linux和Windows操作系统。 无论使用哪个操作系统,Ollama项目的安装过程都设计得非常简单。 访问 https://ollama.com/download 下载对应系统的安装文件。
1、Linux 系统执行以下命令安装:
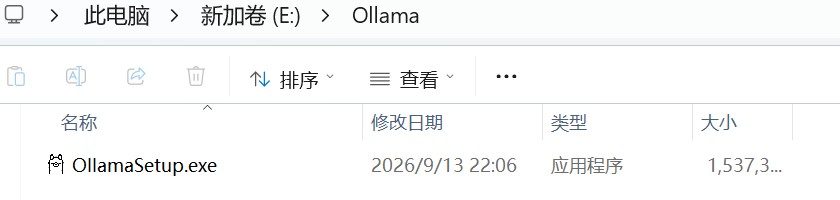
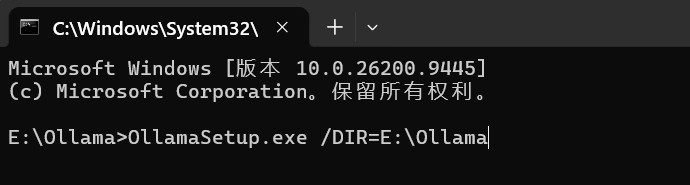
2、Windows 系统的安装过程如下 手动创建ollama安装目录:首先在你想安装的路径下创建好一个新文件夹,并把ollama的安装包放在里面。如:E:\Ollama
然后在cmd 窗口输入:
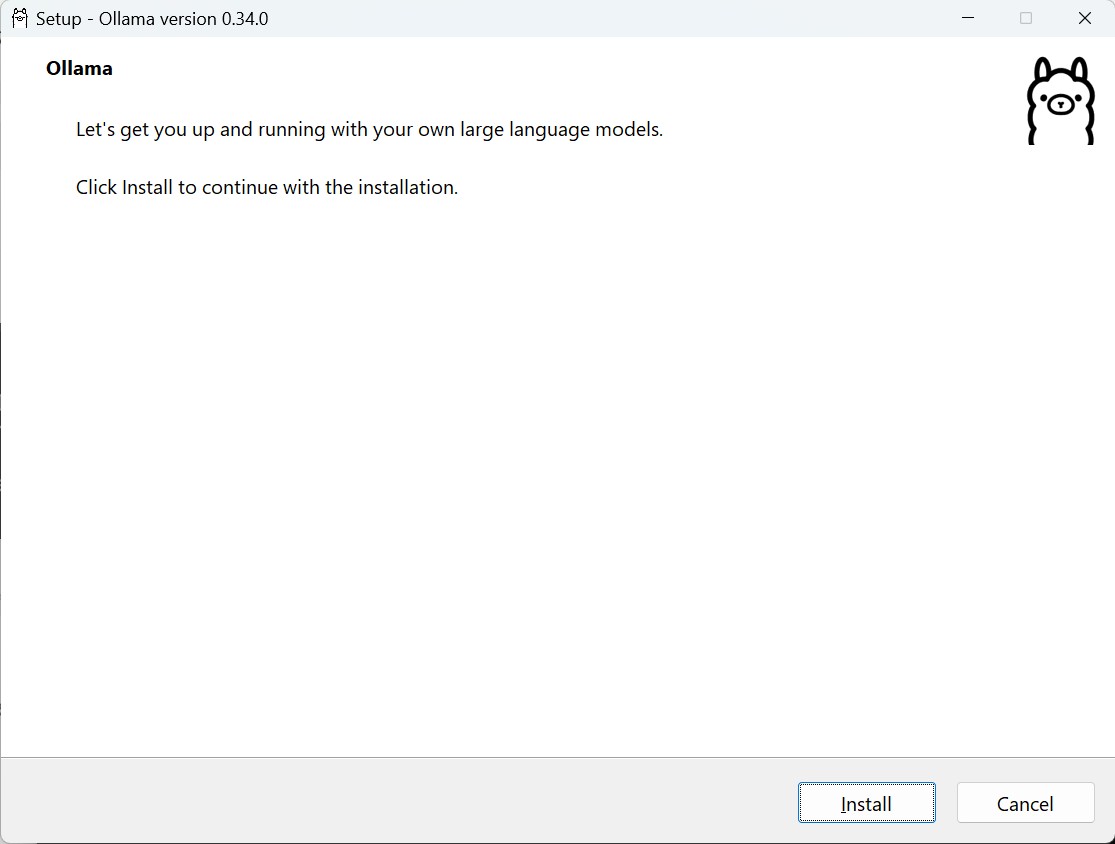
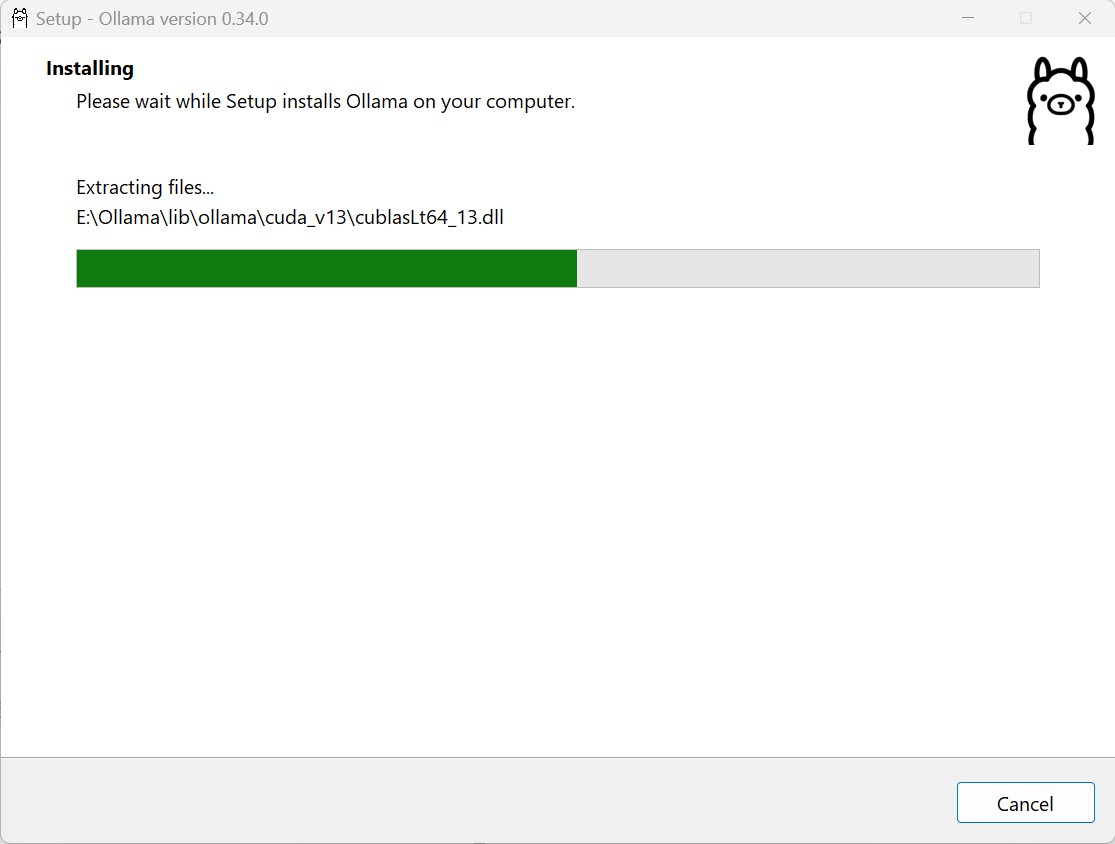
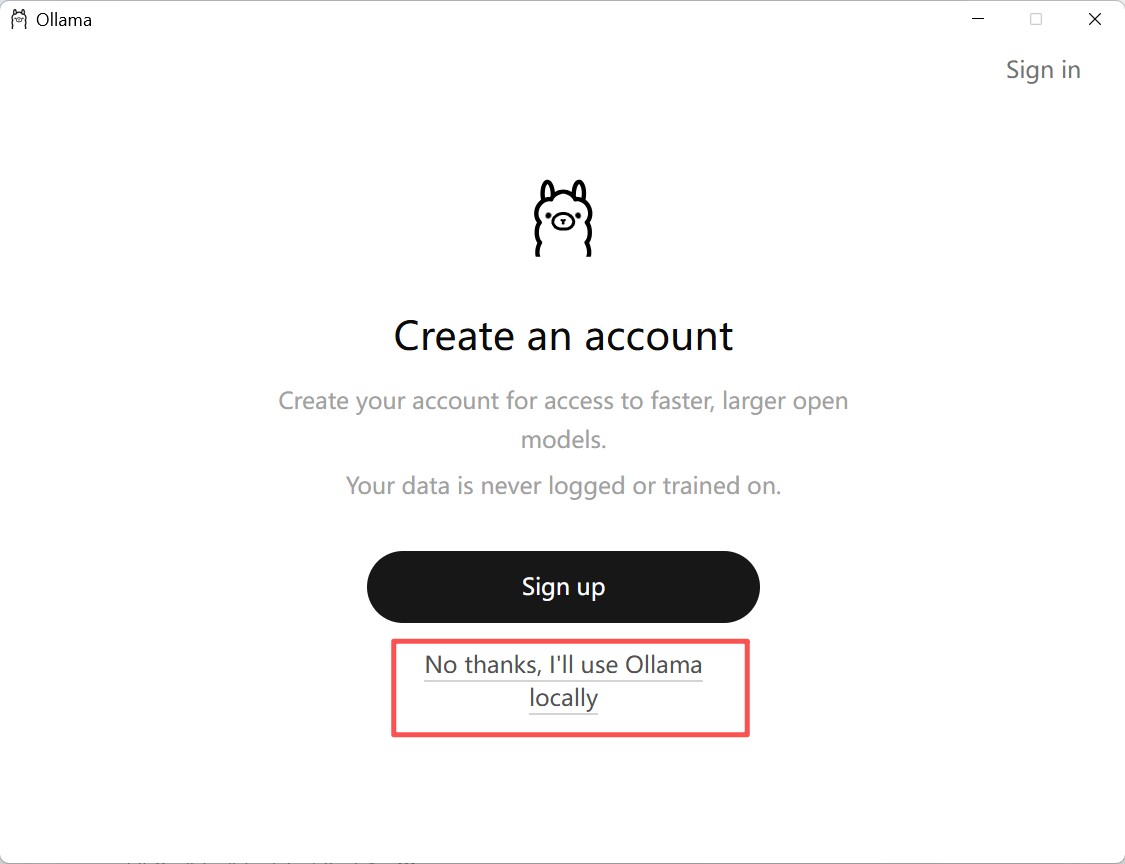
然后 Ollama 就会进入安装,点击 install 后,可以看到 Ollama 的安装路径就变成了指定的目录了。
安装完之后
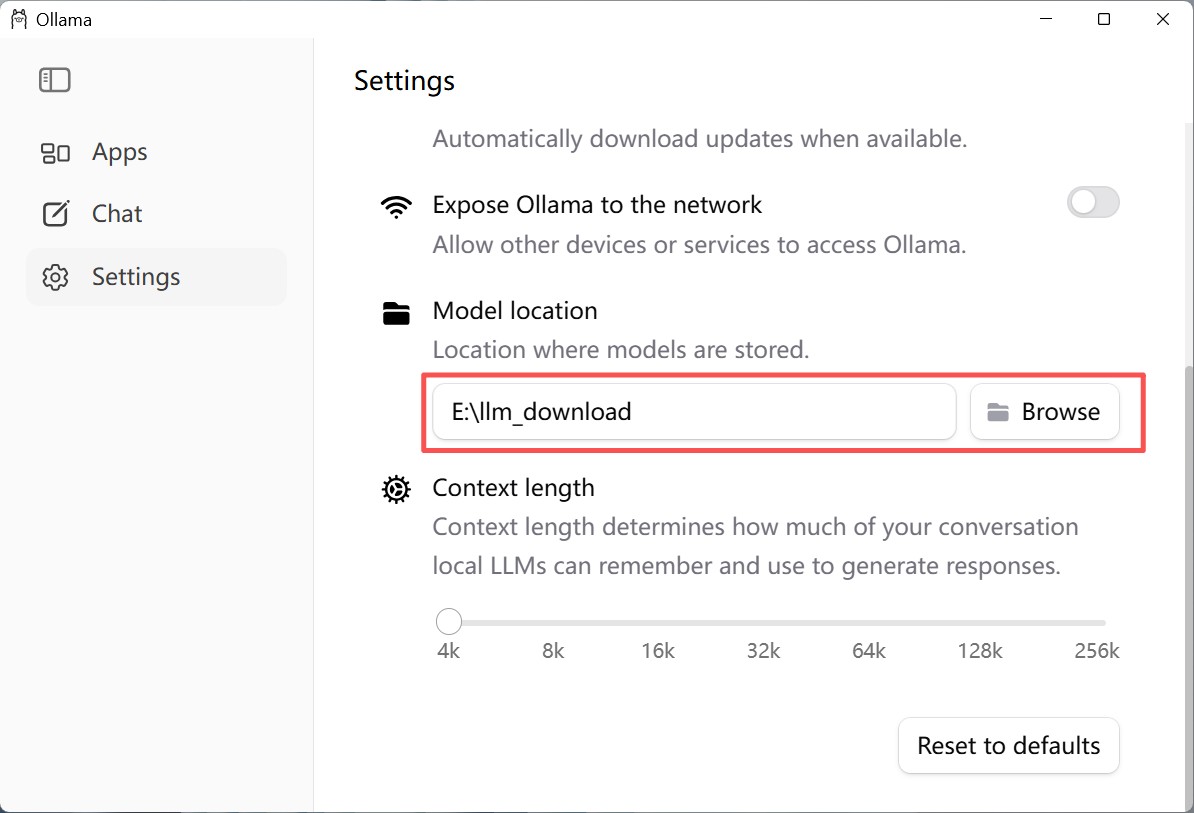
3. 模型的下载1、手动设置大模型存储目录: 指明大模型要下载到的本地目录位置
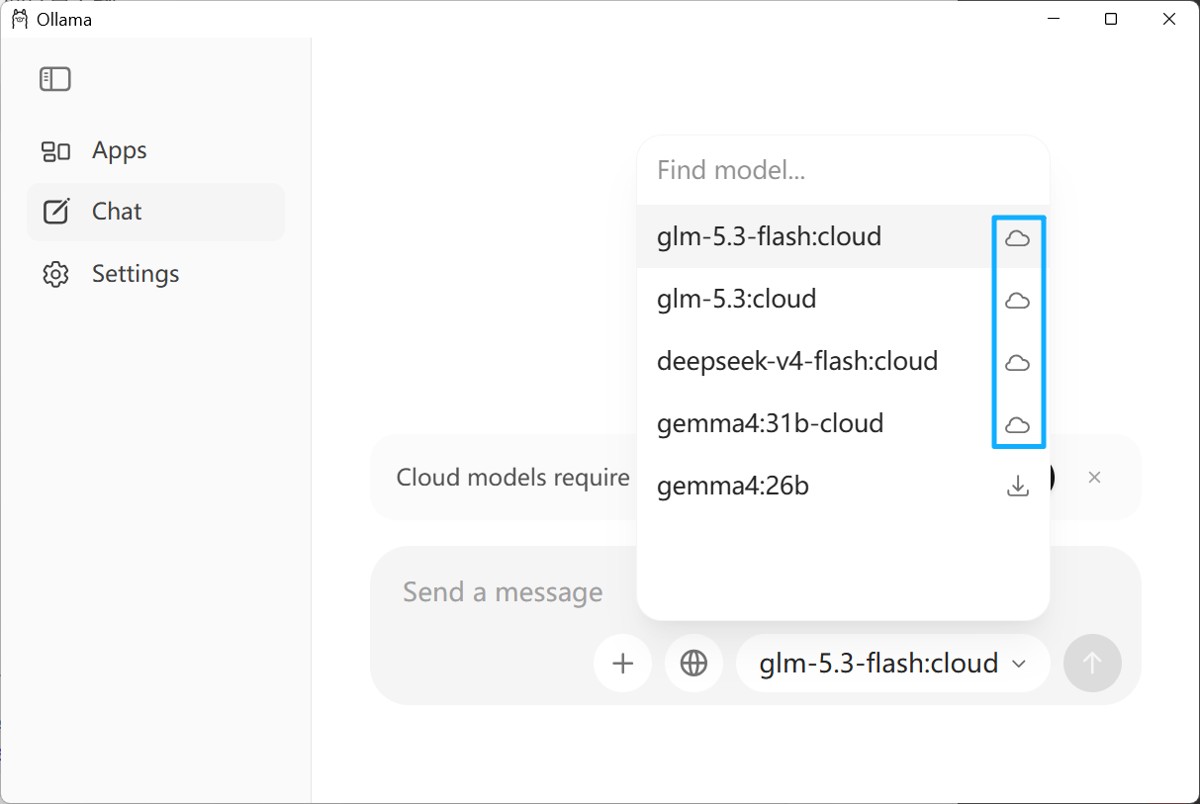
2、模型的下载 方式1:直接在图形化界面位置下载 蓝色的使用在线模型,需要在Ollama平台付费使用
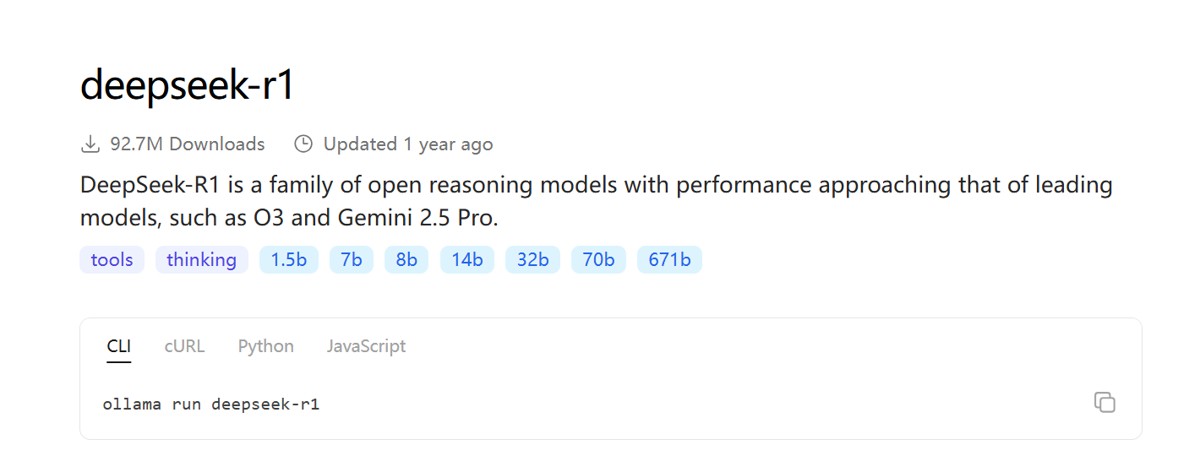
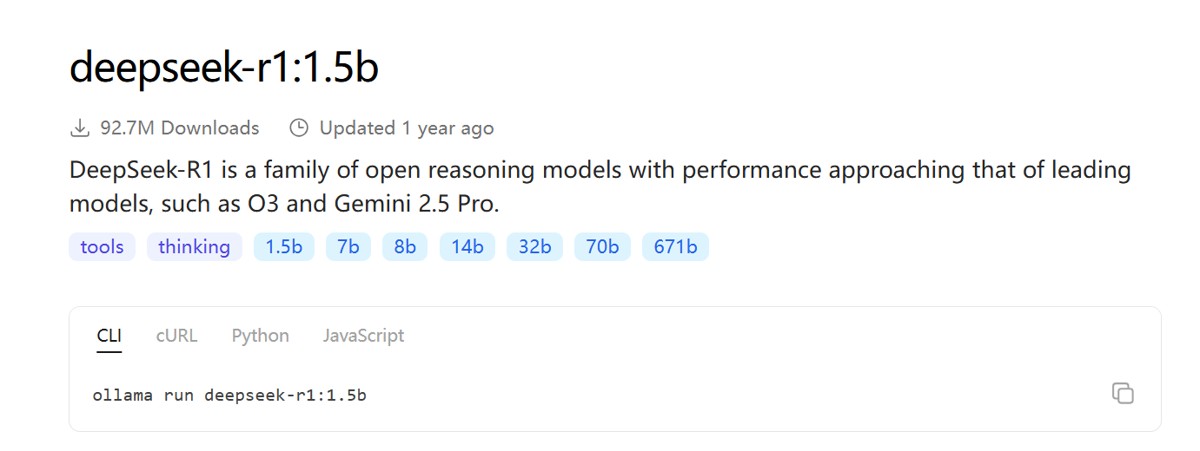
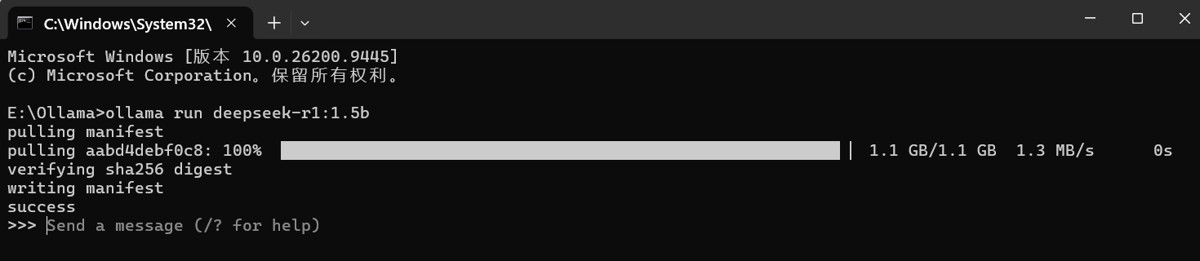
方式2:访问 https://ollama.com/search 可以查看 Ollama 支持的模型。使用命令行可以下载并运行模型,例如运行 deepseek-r1:1.5b 模型:
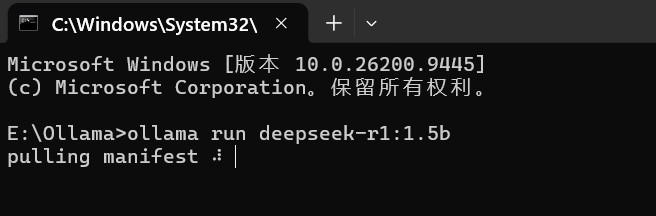
回到命令行,输入指令开始下载:
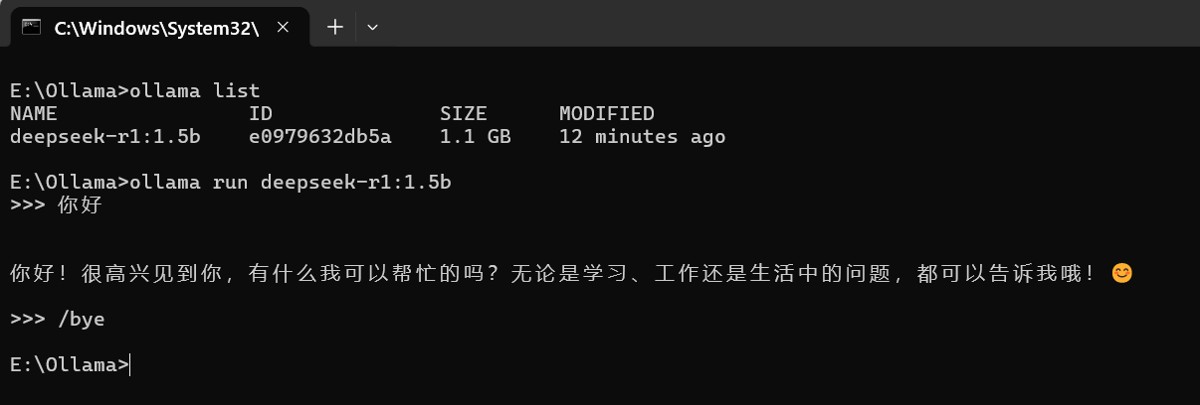
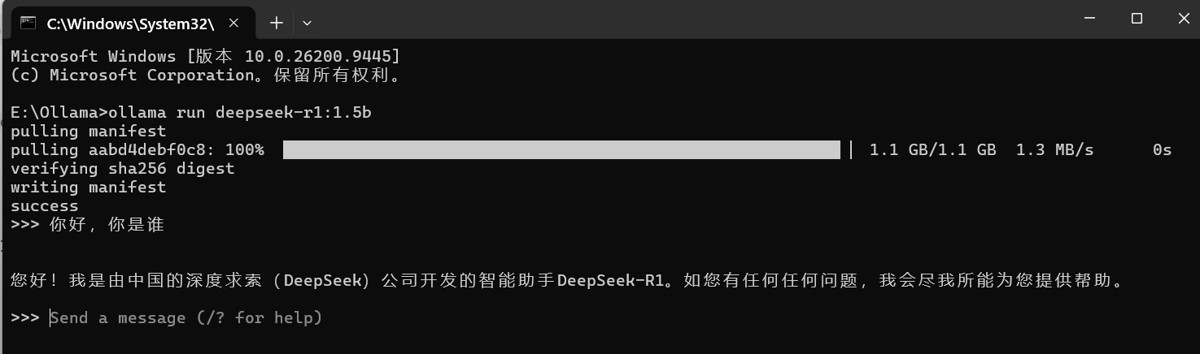
下载完即可进行交互:
后续再唤起模型对话,直接输入:
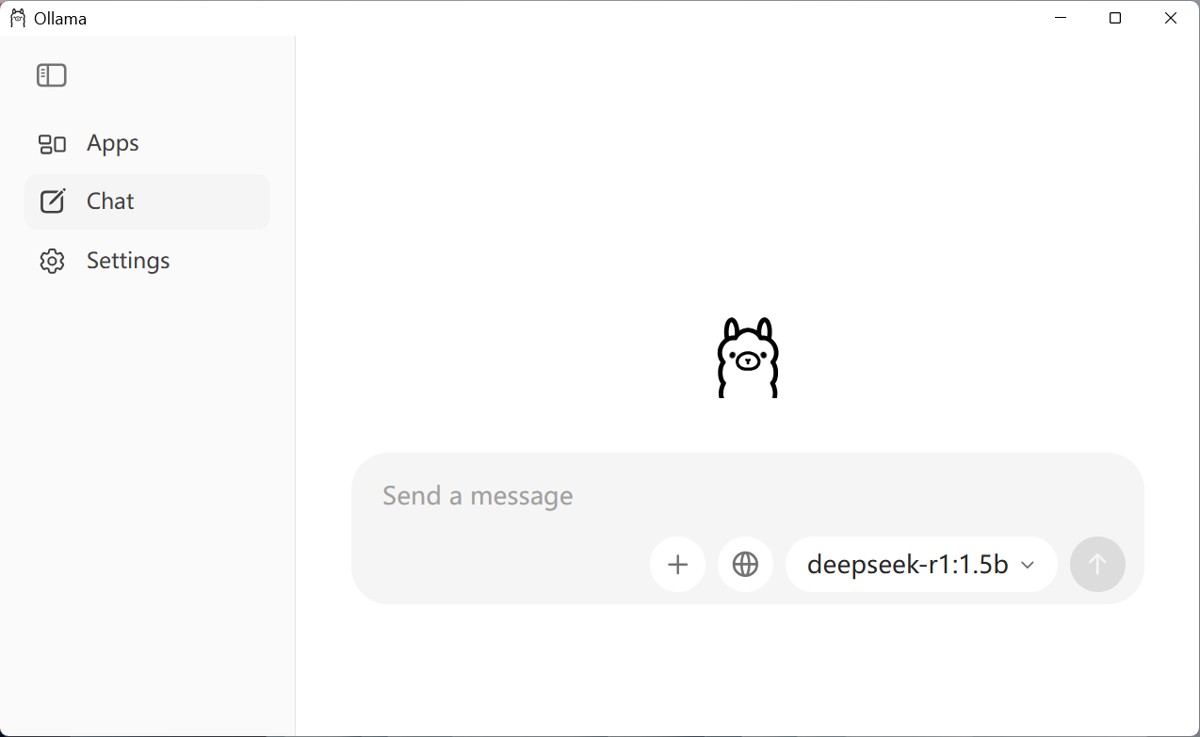
后续也可以在窗口直接对话
4. Ollama常用命令
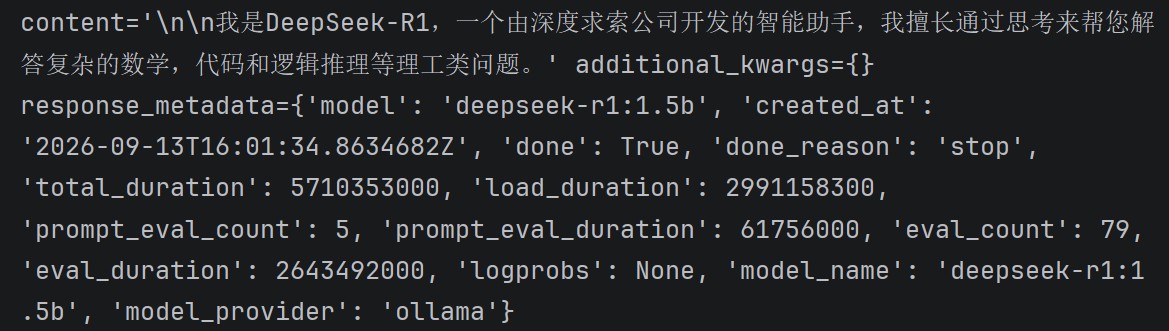
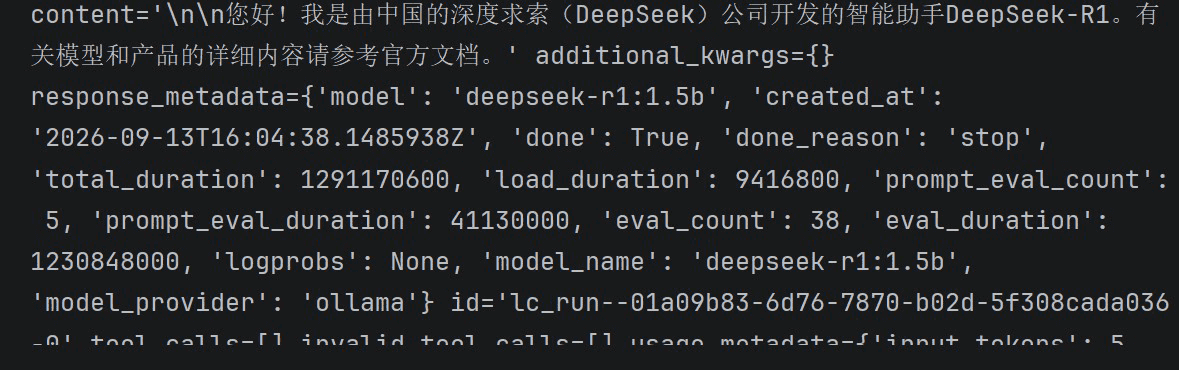
5. LangChain调用模型LangChain整合Ollama调用本地大模型:
方式1:使用ChatOllama
方式2:使用 init_chat_model()
|
您可能感兴趣的文章 :
- DeepSeek Harness基于大模型网关的踩坑指南
- DeepSeek Harness基于大模型网关的踩坑介绍
- Codex CLI配置自定义AI API的完整指南:从环境准备到多模型切换
- OpenClaw配置DeepSeek模型卡在"Required"的终极解决方法
- Claude Code接入Ollama本地大模型的完整介绍
- Windows部署OpenClaw AI Agent从环境配置到模型接入的完整教程
- Ollama本地私有化大模型完整工程
- OpenAI Codex CLI完整实操:模型切换、权限管控、AGENTS.md
- Codex接入第三方模型的完整教程(CLI与桌面端通用配置)
- 在OpenClaw中连接并使用本地Ollama模型的操作

-
Claude Mods是什么?Function Hooks、内置Mod与试用方法
Claude Mods 是 Claude Code 正在开发的新扩展机制,以 TypeScript 函数修改命令、工具调用、界面和安全策略。Anthropic 于 2026 年 9 月 9 日确认该名称 -
DeepSeek Harness之dsh框架的动态System Prompt组装机制与
在构建多Agent协作系统时,System Prompt的编排往往成为隐藏的技术债务。当插件数量增长、上下文动态变化时,传统的字符串拼接方案会暴露 -
Ollama本地大模型部署指南:Ollama安装和LangChain调用
本文以 Ollama 为例,介绍如何在本地部署并运行大模型。内容包括 Ollama 的跨平台安装(Linux/Windows)、模型下载与交互、常用命令速查,以及 -
2026年DeepSeek V4.1 Flash部署完整介绍
适用读者:MLOps 工程师、私有化部署团队、想本地跑 DeepSeek 的开发者 DeepSeek V4.1 Flash 部署指的是把深度求索(DeepSeek)2026 年 9 月 10 日以 -
Windows下DeepSeek Harness 7个高频报错一次性解决方法
先说结论:这不是教程,这是事故现场实录。我在 Windows 上折腾 DeepSeek Harness(后面统一叫 DSH),原计划一小时收工,结果把一晚上过成了 -
Codex安全盲区代码漏洞生成实测
引言:AI 编程助手的安全隐忧 随着 Codex 等 AI 编程助手在开发流程中的普及,开发者对代码生成效率的依赖日益加深。然而,在追求速度的 -
DeepSeek Harness基于大模型网关的踩坑指南
基于一次完整的 Windows 环境安装、插件配置、自定义网关接入的实战记录整理。 一、环境准备阶段 坑 1:Node 版本检查与 nvm 使用 现象:执 -
从 Claude Code 的 187 种 Loading 文案看 AI Agent 用户体
1. 项目概述:从等待焦虑到等待美学 不知道你有没有过这样的体验:在IDE里跑一段代码,或者启动一个需要联网加载数据的AI工具时,那个 -
Codex Git Worktree完整指南:并行开发、分支隔离与
Codex Git Worktree 是把 Codex 聊天任务放进独立 Git 工作树的开发方式:每个任务拥有自己的文件检出和工作目录,同时共享仓库的提交与分支元 -

DeepSeek Harness基于大模型网关的踩坑介绍
基于一次完整的 Windows 环境安装、插件配置、自定义网关接入的实战记录整理。 一、环境准备阶段 坑 1:Node 版本检查与 nvm 使用 现象:执
-
Hermes Desktop极简安装教程
2026-07-02
-
Codex下载与登录全流程分析(Windows/ma
2026-06-24
-
从零到高效开发介绍Codex本地安装与使
2026-06-01
-
Claude Code配置本地Ollama模型或别的模型
2026-06-27
-
Codex安装、入门和快速使用的新手教程
2026-06-02