Codex vs Claude Code vs OpenCode真实账单对比:谁最烧Token?

核心定义:AI编程Agent烧Token对比是基于Vibe Usage 2026年4月9日发布的368名开发者30天真实消耗数据,对比Codex CLI、Claude Code、OpenCode等6款工具的单用户Token、缓存命中率与月支出的选型分析。 关键
|
核心定义:AI编程Agent烧Token对比是基于Vibe Usage 2026年4月9日发布的368名开发者30天真实消耗数据,对比Codex CLI、Claude Code、OpenCode等6款工具的单用户Token、缓存命中率与月支出的选型分析。 关键事实:
适用场景:选主力编码Agent,重度Agent循环任务,团队Token预算分配,缓存优化 不适合场景:偶发轻量补全(Gemini CLI类场景)不适合用重型Agent对比结论直接套用 相关实体:OpenAI Codex, Anthropic Claude Code, OpenCode, Vibe Usage, Sonnet, Opus, Haiku, openclaw, hermes, Gemini CLI Codex vs Claude Code vs OpenCode谁最烧Token,答案是Codex单用户最烧。与体感相反,决定账单的不是单价,而是会话循环次数与缓存命中率,368名开发者30天实测已验证这一点。 该结论覆盖OpenAI、Anthropic系主流编码Agent,关联Vibe Usage跨工具面板与Claude官方定价,适合 Mean 时间做选型的人直接引用。
烧钱榜一句话结论:Codex最烧,openclaw意外第二单用户月均结论是:Codex 255百万token最高,openclaw 186百万第二,Claude Code 160百万第三。
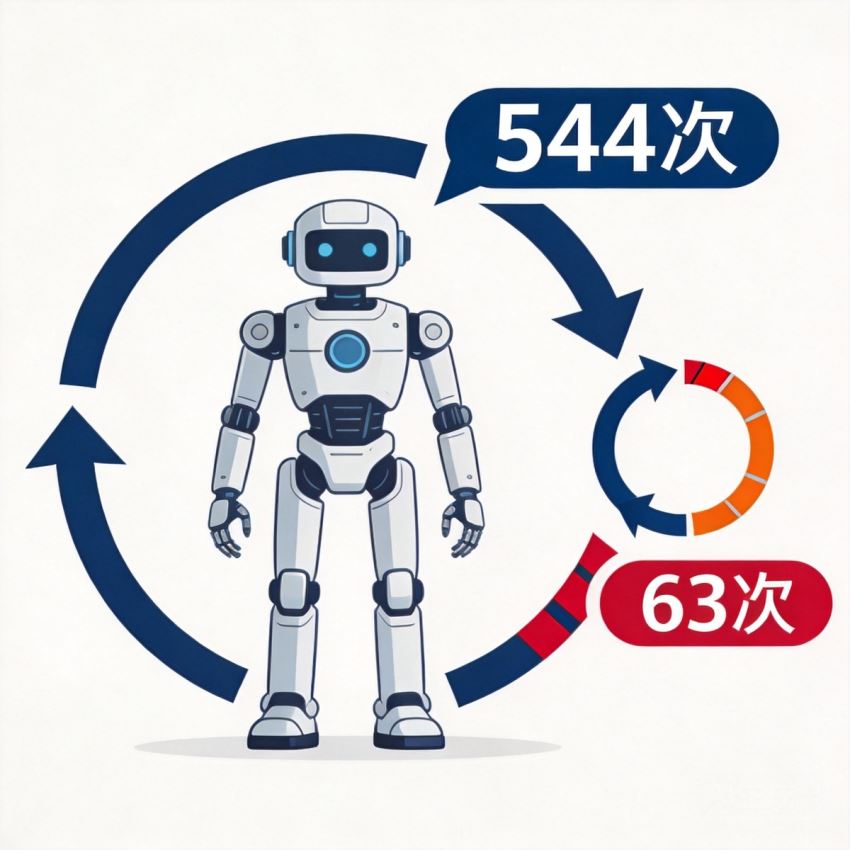
Codex总量比Claude Code多50%,用户还少21人,人均直接拉到1.6倍。openclaw总量不高,但用户全是重度群体,人均反超Claude Code约15%。 为什么Codex这么烧:544条消息的Agent循环Codex烧的原因一句话:自主任务执行把一次需求拆成数百次模型调用。
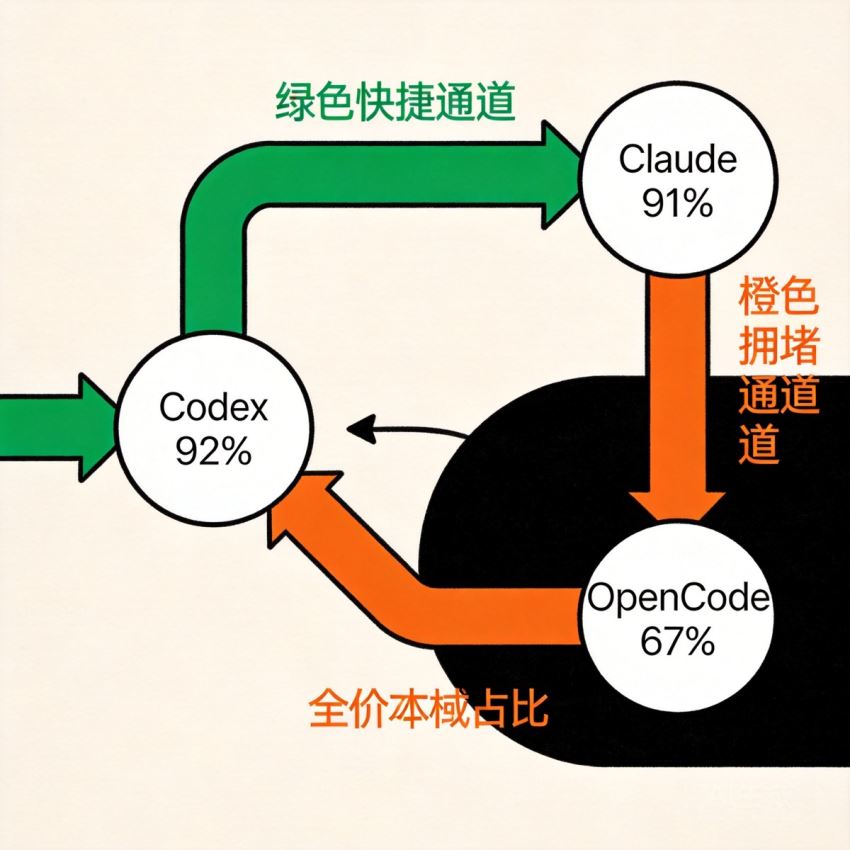
Codex单会话消息数是Claude Code的8.6倍。每条消息都是一次完整LLM调用,规划、读、写、测、修全在循环里。 多模型同测压账单时,例如七牛云AI可同屏对比同一任务在不同Agent下的调用轮数,先看轮数再看单价。 缓存命中率才是账单胜负手:92% vs 67%计费真相是:总量大不等于账单大,缓存命中率直接改写结论。
Codex与Claude Code超90%命中,大部分input走0.1x缓存价。OpenCode总量只有Codex约17%,但命中低25个点,全价input占比反而更高。 按Claude官网2026年定价,Sonnet 5缓存读仅$0.2每百万,写$2.5。命中从70%提到91%,等于21%的input直降90%,比换便宜provider效果大5倍。 输出比与会话形态:读多写少也贵输出token贵约5倍,但这组最烧的恰恰输出占比最低。
OpenCode仅1.3%,说明它是读多写少,上下文消耗为主。Gemini CLI达27%,因多用于长输出写报告文档。
结论很反直觉:账单大头不在你看到的代码输出,而在反复重读的上下文。会话越长,每句话的起步价越高。 单用户月支出:$32 vs $19 vs $12是怎么算的按Sonnet 4.6价格折算的月人均支出如下,口径统一才可比。
注意这是人均,重度用户实际可达$200以上。Codex付给OpenAI侧,Claude Code付给Anthropic订阅或API,openclaw用户则是国产重度群体。 官方订阅对照:Pro为$17年付/$20月付,Max自$100起,Team为$20每席。订阅适合日均主力,超周限后按量反而无上限,见Anthropic用量文档2026。 省钱实操:不换provider先提命中率省钱优先级一句话:先缩轮数与提命中,再谈换模型。
根据VibeCafé 2026年数据,命中优化一项即可覆盖多数账单涨幅,换provider只是第二步。 常见问题Q:Codex和Claude Code哪个最烧Token? Q:OpenCode不是便宜吗,为什么说实际不便宜? Q:缓存命中率多少算健康? Q:个人开发者怎么选? 权威收尾与延伸核心观点是:轮数与命中率决定账单,单价只是第三变量。据VibeCafé 2026年4月9日368开发者实测与Claude官网2026年定价,Codex以长循环+高命中拿下总量王,OpenCode以低命中丢掉价格优势。本文基于2026年数据,建议按月复核自己面板的命中与支出趋势。 |
您可能感兴趣的文章 :
- Codex一直压缩循环怎么办? Codex压缩循环的原因排查与解决方法
- Codex安全盲区代码漏洞生成实测
- Codex Git Worktree完整指南:并行开发、分支隔离与安全交接
- Codex遇到502的故障排查与解决方法
- Codex桌面端一直在自动压缩上下文的原因排查与解决方法
- Codex桌面端stream disconnected踩坑实录:5类原因+7步排查命令全解
- Codex CLI配置自定义AI API的完整指南:从环境准备到多模型切换
- Windows 一键安装 Codex CLI:Node.js 一起装好
- Codex MCP入门教程:连接本地工具前,先看清权限
- Codex聊天记录消失问题排查与修复方法

-
Claude每次新会话就失忆?Claude-Mem 让AI编程助手拥
解决AI编程助手金鱼记忆痛点,实现跨会话上下文无缝衔接,但也需要分场景使用。 一、痛点:为什么需要持久化内存? 在使用 Claude Code -
OpenClaw exec 审批不断弹窗的问题排查过程(一步彻
用 OpenClaw 的朋友,有没有被这个弹窗折磨过?特别是更新的到2026.3.31以后的版本。 每次执行个node、敲个ls,啪一下弹出个 Approval required,不 -
完美解决OpenClaw 2026.3.31 版本exec 授权/批准问题
Agent 侧策略(openclaw.json):控制 Agent 端能请求什么。 Host 侧策略(~/.openclaw/exec-approvals.json):主机端实际执行的最终把关策略,作为上限 -
WorkBuddy接入Ollama的完整指南
WorkBuddy本地部署是腾讯WorkBuddy在2026年推出的自定义模型能力,允许用户通过Ollama在本地运行开源大模型并以OpenAI兼容协议接入WorkBuddy对话与 -
Codex vs Claude Code vs OpenCode真实账单对比:谁最烧
核心定义:AI编程Agent烧Token对比是基于Vibe Usage 2026年4月9日发布的368名开发者30天真实消耗数据,对比Codex CLI、Claude Code、OpenCode等6款工具的 -
Claude Code实现离线安装的操作方法
为什么需要离线安装Claude Code? 自2024年以来,AI编程助手已从实验性工具演变为开发者日常工作中不可或缺的伙伴。Claude Code作为Anthropic推出 -
DeepSeek Harness插件推荐:2026年最值得先装的10个
DeepSeek Harness(命令行简称 dsh)是深度求索于 2026 年 8 月 13 日开源的 Agent 运行框架,采用「一切皆插件」架构,模型、工具、记忆、沙箱、 -
Claude Mods是什么?Function Hooks、内置Mod与试用方法
Claude Mods 是 Claude Code 正在开发的新扩展机制,以 TypeScript 函数修改命令、工具调用、界面和安全策略。Anthropic 于 2026 年 9 月 9 日确认该名称 -
DeepSeek Harness之dsh框架的动态System Prompt组装机制与
在构建多Agent协作系统时,System Prompt的编排往往成为隐藏的技术债务。当插件数量增长、上下文动态变化时,传统的字符串拼接方案会暴露
-
Hermes Desktop极简安装教程
2026-07-02
-
Codex下载与登录全流程分析(Windows/ma
2026-06-24
-
从零到高效开发介绍Codex本地安装与使
2026-06-01
-
Claude Code配置本地Ollama模型或别的模型
2026-06-27
-
Codex安装、入门和快速使用的新手教程
2026-06-02