一、通配符
通配符也叫文件名替换,它主要是作用于匹配文件名,常用命令是ls、find、cp、mv。
主要用于匹配文件名
| 符号 | 作用 |
|---|---|
| * | 匹配任意(0个或多个)字符或字符串,包括空字符串 |
| ? | 匹配任意1个(单个)字符,有且只有一个字符 |
| [abcd] | 匹配abcd中任何一个字符,abcd也可是其他任意不连续字符 |
| [0-9] | 匹配数字0-9之间的任意一个数字 |
| [a-z] | 匹配中a到z之间的任意一个字符, a到z表示范围,字符前后要连续,-表示范围的意思 |
| [!abcd] | 同[^abcd],表示不匹配括号里面的任何一个字符,也可为[!a-d] |
ls -d 通配符 -d只列出目录本身,不显示里面的内容
|
1 2 3 4 5 |
ls -d *.txt 列出当前目录下所有以.txt结尾的文件 ls -d /data/*.txt 列出指定目录/data下的所有以.txt结尾的文件 ls -d a* 列出当前目录下以a开头的文件 ls -d a?b 列出当前目录下以a开头中间有任意一个字符以b结尾的文件 ls -d [aln]* 列出当前目录下以a/l/n开头的文件 |
| 常见的字符集 | 作用 |
|---|---|
| [:alpha:] | 表示所有的字母(不区分大小写)= [a-Z] |
| [:alnum:] | 表示任意单个字母或数字(不区分大小写)= |
| [:lower:] | 表示任意单个小写字母 = [a-z] |
| [:upper:] | 表示任意单个大写字母 = [A-Z] |
| [:digit:] | 表示任意单个数字 = [0-9] |
使用字符集时用中括号[]包起来
|
1 |
ls -d *[[:digit:]] 表示当前目录下以数字结尾的文件 |
二、正则表达式
又称“规则表达式”。regex
正则表达式使用单个字符串来描述、匹配一系列符合某个语法规则的字符串。
用来匹配文件名,在文本编辑器中,用来匹配特定文本内容,替换文本内容。
字符匹配
-
. 匹配任意单个字符
-
[] 匹配指定范围内的任意单个字符
-
[^] 匹配指定范围外的任意单个字符
特殊表示
| 常见的字符集 | 作用 |
|---|---|
| [:alpha:] | 表示所有的字母(不区分大小写)= [a-Z] |
| [:alnum:] | 表示任意单个字母或数字(不区分大小写)= |
| [:lower:] | 表示任意单个小写字母 = [a-z] |
| [:upper:] | 表示任意单个大写字母 = [A-Z] |
| [:digit:] | 表示任意单个数字 = [0-9] |
| [:space:] | 任何会产生空白的字符,包括空白键, [Tab], CR 等等 |
匹配次数
\用于转义,这里的 { 和 } 和 ?和 + 前面都有一个转义符\
| 符号 | 作用 |
|---|---|
| * | 匹配其前面的字符任意次(0次、1次或多次) |
| .* | 匹配任意长度的任意字符 |
| \? | 匹配起前面字符0次或1次 |
| + | 匹配其前面字符1次或多次 |
| {m} | 匹配其前面的字符m次 |
| {m,n} | 匹配其前面字符最少m次,最多n次 |
| {m,} | 匹配其前面字符最少m次 |
| {,n} | 匹配其前面字符最多n次 |
匹配位置
^:行首锚定
$:行尾锚定
^$:匹配空白行
\<或\b:词首锚定
\>或\b:词尾锚定
\<PATTERN\>:匹配完整的单词
分组
()
中间使用|表示或 (a|b)a或b
三、扩展正则表达式
基本正则表达式需要转义符\,扩展正则表达式不需要转义符\
| 基本正则表达式 | 意义 | 扩展正则表达式 | 意义 |
|---|---|---|---|
| . | 匹配任意单个字符 | . | 匹配任意单个字符 |
| [] | 匹配指定范围内的任意单个字符 | [] | 匹配指定范围内的任意单个字符 |
| [^] | 匹配指定范围之外的任意单个字符 | [^] | 匹配指定范围之外的任意单个字符 |
| * | 匹配其前边的字符任意次(0次,或者多次,不能单独使用) | * | 匹配其前边的字符任意次(0次或多次,不能单独使用) |
| .* | 匹配任意长度的任意字符 | .* | 匹配任意长度的任意字符 |
| + | 匹配其前边的字符一次或者多次(匹配至少1次) | ||
| \? | 匹配其前边的字符0次或者1次 | ? | 匹配前边的字符0次或者1次 |
| \{m,n\} | 匹配前边的字符至少m次,最多n次 | {m,n} | 匹配前边的字符至少m次,最多n次 |
| ^ | 匹配行首,此字符后边的任意内容必须出现在行首 | ^ | 匹配行首,此字符后边的任意内容必须出现在行首 |
| $ | 匹配行尾,此字符前边的任意内容必须出现在行尾 | $ | 匹配行尾,此字符前边的任意内容必须出现在行尾 |
| ^$ | 匹配空白行 | ^$ | 匹配空白行 |
| \< 或 \b | 匹配词首,其后面的任意字符必须作为单词首部出现 | \< | 匹配行首,其后面的任意字符必须作为单词首部出现 |
| \>或\b | 匹配词尾,其前面的任意祖父必须作为单词的尾部出现 | \> | 匹配词尾,其前面的任意祖父必须作为单词的尾部出现 |
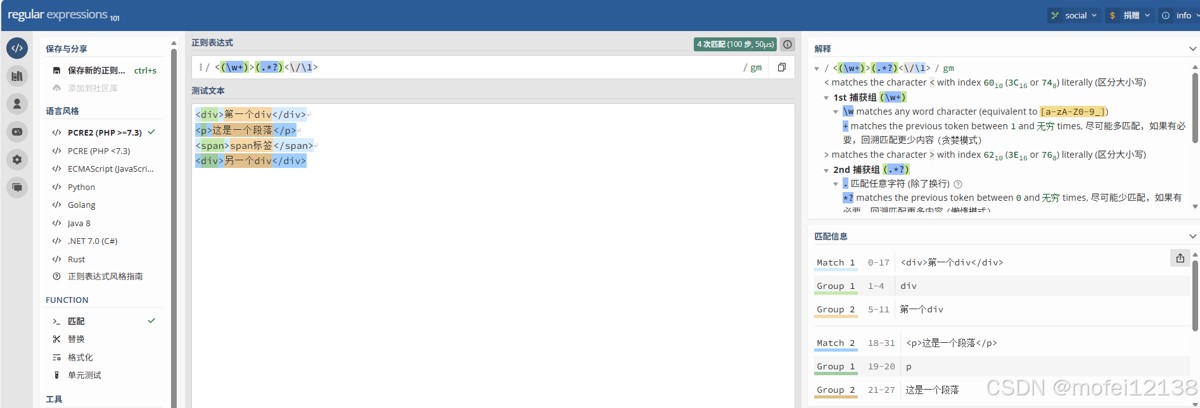
| \(\) | 分组匹配,会将() 内匹配的内容保存起来,后边可以使用\1 或者 \2 的位置信息进行引用 | () | | 分组匹配,会将() 内匹配的内容保存起来,后边可以使用\1 或者 \2 的位置信息进行引用 |
|
1 |
\s : 匹配空白符,包括空格、制表符、换行符等 |
原文链接:
相关文章