使用正则表达式解析HTML的实用介绍

引言 在 Web 开发和数据采集工作中,经常需要从 HTML 页面中提取信息。虽然 HTML 解析库(如 BeautifulSoup、jsoup、HtmlAgilityPack 等)是更稳妥的选择,但在某些轻量场景下,使用正则表达式解析 H
引言在 Web 开发和数据采集工作中,经常需要从 HTML 页面中提取信息。虽然 HTML 解析库(如 BeautifulSoup、jsoup、HtmlAgilityPack 等)是更稳妥的选择,但在某些轻量场景下,使用正则表达式解析 HTML 仍然是一种快速、直接的方案。本文将从基础概念出发,介绍如何使用正则表达式解析 HTML,并给出常见场景的实用示例。 2. 正则表达式基础回顾在开始解析 HTML 之前,先回顾几个常用的正则表达式语法元素:
解析 HTML 时,最常用的是非贪婪匹配和分组捕获,因为它们能精准提取标签之间的内容。 3. 解析 HTML 的常见场景下面通过几个典型场景,演示如何使用正则表达式从 HTML 中提取信息。 3.1 提取链接和文本假设有一段 HTML 包含多个链接,需要提取每个链接的 URL 和锚文本:
这里 ([^"]+) 捕获 href 属性值,([^<]+) 捕获标签内的文本内容。 3.2 提取图片地址提取 <img> 标签中的 src 属性:
3.3 提取表格数据从简单的 HTML 表格中提取每一行的单元格内容:
这里使用 re.S 标志,让点号也能匹配换行符,从而正确处理跨行的表格内容。 4. 正则表达式解析 HTML 的注意事项虽然正则表达式可以完成简单的 HTML 解析,但在实际使用中需要注意以下几点:
因此,对于结构复杂或不可控的 HTML,建议优先使用专门的解析库;正则表达式更适合处理格式相对固定、结构简单的片段。 5. 总结本文介绍了如何使用正则表达式解析 HTML,包括提取链接、图片地址和表格数据等常见场景,并总结了使用正则表达式解析 HTML 的优缺点。在实际项目中,应根据 HTML 的复杂程度选择合适的工具:简单场景用正则表达式快速解决,复杂场景则交给专业的 HTML 解析库。 |
您可能感兴趣的文章 :

-
使用正则表达式解析HTML的实用介绍
引言 在 Web 开发和数据采集工作中,经常需要从 HTML 页面中提取信息。虽然 HTML 解析库(如 BeautifulSoup、jsoup、HtmlAgilityPack 等)是更稳妥的选 -
通配符和正则表达式介绍
一、通配符 通配符也叫文件名替换,它主要是作用于匹配文件名,常用命令是ls、find、cp、mv。 主要用于匹配文件名 符号 作用 * 匹配任意( -
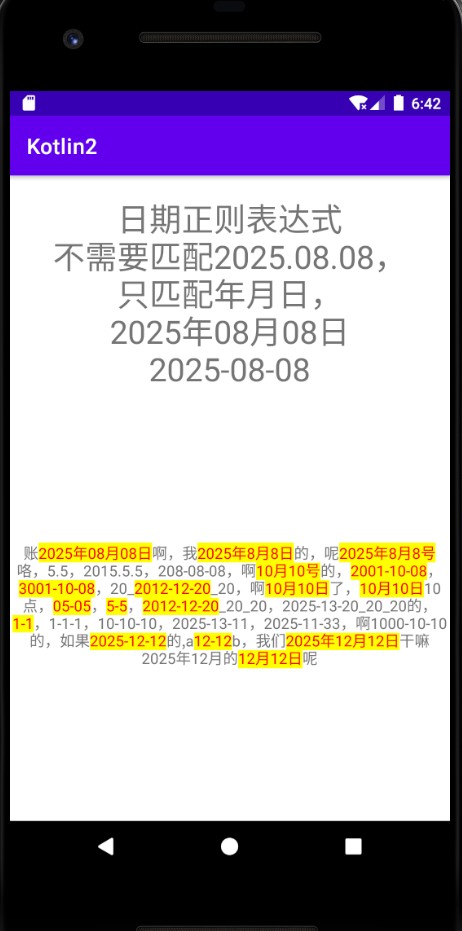
kotlin正则表达式识别年月日代码
kotlin - 正则表达式,识别年月日 1 !--正则表达式日期识别,不需要处理2025.08.08的日期-- string name=date_regex(?:^|(?lt;![-\\d]))(?:(?:[2-9][0-9]{3}[-年] -
正则表达式位置匹配应用介绍
正则表达式中的位置匹配(锚点) 正则表达式不仅能匹配字符,还能匹配位置(也称为锚点或锚定)。位置匹配不消耗任何字符,只指定匹 -
正则表达式IP地址合法性判断
一、正则表达式常见匹配字符快速回顾 符号 描述 . 匹配处换行符\n之外任意1个字符 [] 匹配[]中任意一个 \d 一个0-9数字 \D 匹配非数字 \w 匹配 -
正则表达式中的特殊符号的介绍
正则表达式中的特殊符号 如: 1 preg_match(/.+?hxx/is, hxx)); 返回,0,表示没有匹配,这是因为.+?的作用,具体讲一下。 .的作用 作用:匹配除换 -
S3标签字符清洗的正则表达式实践记录
深入理解 S3 标签字符清洗的正则表达式实践 在构建与 AWS S3 相关的服务时,尤其是使用 S3 标签(Tag)作为资源标识或元数据时,确保标签值
-
Java正则表达式里隐藏的陷阱
2021-06-04
-
Python中正则表达式的巧妙使用一文包
2019-05-27
-
如何使用正则表达式对输入数字进行
2022-10-12
-
最实用的正则表达式的整理
2022-10-12
-
正则表达式去除中括号(符号)及里
2019-06-26